

এআই প্রশিক্ষণে জিপিইউ সার্ভারের ভূমিকা বোঝা
আধুনিক কৃত্রিম বুদ্ধিমত্তা (এআই) মডেলগুলো প্রশিক্ষণের সময় শত কোটি—এমনকি কয়েক ট্রিলিয়ন—গাণিতিক হিসাব সম্পন্ন করে। আপনি যদি একটি কম্পিউটার ভিশন মডেল তৈরি করেন, একটি লার্জ ল্যাঙ্গুয়েজ মডেল (এলএলএম) প্রশিক্ষণ দেন, একটি ফাউন্ডেশন মডেল ফাইন-টিউন করেন, অথবা একটি জেনারেটিভ এআই অ্যাপ্লিকেশন তৈরি করেন—এই কাজগুলোর জন্য বিশাল পরিমাণ সমান্তরাল গণনা প্রয়োজন, যা প্রচলিত সিপিইউ-ভিত্তিক সার্ভার দক্ষতার সাথে সরবরাহ করতে পারে না। এই কারণেই প্রতিষ্ঠানগুলো এআই প্রশিক্ষণের জন্য ক্রমবর্ধমানভাবে জিপিইউ সার্ভারের উপর নির্ভর করছে, যা দ্রুত মডেল উন্নয়ন, কম প্রশিক্ষণ চক্র এবং কম্পিউটিং রিসোর্সের আরও দক্ষ ব্যবহার নিশ্চিত করে।
একটি এআই প্রশিক্ষণের জন্য জিপিইউ সার্ভার হলো একটি উচ্চ-ক্ষমতাসম্পন্ন কম্পিউটিং সিস্টেম, যা এক বা একাধিক গ্রাফিক্স প্রসেসিং ইউনিট (জিপিইউ) দিয়ে তৈরি, যা একসাথে হাজার হাজার সমান্তরাল অপারেশন সম্পন্ন করতে পারে। সিপিইউ যেখানে ধারাবাহিক প্রক্রিয়াকরণ ও সাধারণ-উদ্দেশ্যমূলক কম্পিউটিংয়ের জন্য অপ্টিমাইজ করা, সেখানে জিপিইউ বিশেষভাবে তৈরি হয়েছে ম্যাট্রিক্স গুণন, টেন্সর অপারেশন, ভেক্টর গণনা এবং ব্যাচ প্রসেসিং ত্বরান্বিত করার জন্য—যা মেশিন লার্নিং এবং ডিপ লার্নিং ফ্রেমওয়ার্ক যেমন পাইটর্চ, টেনসরফ্লো এবং জ্যাক্স-এর মূল গণনামূলক কাজ। শুধুমাত্র সিপিইউ-নির্ভর অবকাঠামোর তুলনায়, একটি এআই জিপিইউ সার্ভার প্রশিক্ষণ থ্রুপুট উল্লেখযোগ্যভাবে বাড়ায়, এপোক সময় কমায়, জিপিইউ ব্যবহারের হার বাড়ায়, এবং প্রাকৃতিক ভাষা প্রক্রিয়াকরণ (এনএলপি), কম্পিউটার ভিশন, সুপারিশ ব্যবস্থা, মাল্টিমোডাল এআই, রিট্রিভাল-অগমেন্টেড জেনারেশন (র্যাগ) এবং জেনারেটিভ এআই-এর মতো কাজগুলোকে দ্রুততর করে তোলে।
তবে, এআই প্রশিক্ষণের জন্য সেরা জিপিইউ সার্ভার শুধুমাত্র একটি শক্তিশালী জিপিইউযুক্ত সার্ভার নয়। উচ্চ-কর্মক্ষমতাসম্পন্ন এআই অবকাঠামোর জন্য প্রয়োজন এমন একটি সুষম স্থাপত্য, যেখানে কম্পিউট, মেমরি, স্টোরেজ এবং নেটওয়ার্কিং একসাথে দক্ষভাবে কাজ করে। জিপিইউ সার্ভার হোস্টিং মূল্যায়নের সময় প্রতিষ্ঠানগুলোর বিবেচনা করা উচিত জিপিইউ স্থাপত্য, কুডা (CUDA) ও সিইউডিএনএন (cuDNN) সামঞ্জস্যতা, জিপিইউ ভিআরএএম ক্ষমতা, ডেটা প্রিপ্রসেসিংয়ের জন্য সিপিইউ কর্মক্ষমতা, সিস্টেম মেমরি, এন্টারপ্রাইজ এনভিএমই এসএসডি স্টোরেজ, নেটওয়ার্কিং ব্যান্ডউইথ এবং স্কেলেবিলিটি। শুধুমাত্র জিপিইউ স্পেসিফিকেশনকে অগ্রাধিকার দেওয়া সিস্টেমগুলোর তুলনায়, একটি সুষম অবকাঠামো বাস্তব জগতে ধারাবাহিকভাবে উন্নত কর্মক্ষমতা প্রদান করে।
এআই প্রশিক্ষণ কর্মপ্রবাহে জিপিইউ সার্ভার কীভাবে খাপ খায়
এআই প্রশিক্ষণ একটি বহু-পর্যায়ের প্রক্রিয়া, যেখানে প্রতিটি অবকাঠামো উপাদান সামগ্রিক কর্মক্ষমতায় অবদান রাখে। প্রথমে ডেটাসেটগুলো সিপিইউ দ্বারা প্রস্তুত ও প্রিপ্রসেস করা হয়, এরপর সেগুলো জিপিইউ মেমরিতে লোড করা হয়। এরপর জিপিইউ ফরওয়ার্ড প্রোপাগেশন, ব্যাকপ্রোপাগেশন, গ্র্যাডিয়েন্ট অপ্টিমাইজেশন এবং প্যারামিটার আপডেটের কাজ সম্পন্ন করে, যখন উচ্চ-গতির এনভিএমই এসএসডি স্টোরেজ ক্রমাগত ডেটাসেট পড়ে এবং মডেল চেকপয়েন্ট লিখে। প্রশিক্ষণ সম্পন্ন হওয়ার পর, তৈরি হওয়া মডেলটি যাচাই, ফাইন-টিউন এবং প্রোডাকশন ইনফারেন্সের জন্য স্থাপন করা যেতে পারে।
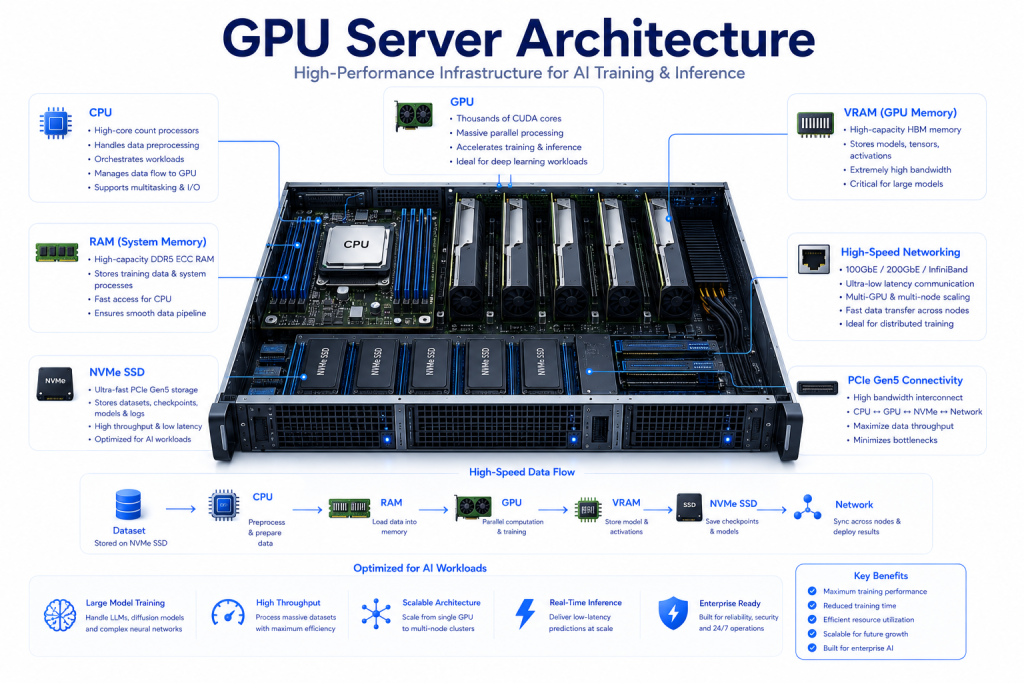
যেহেতু প্রতিটি পর্যায় কম্পিউট, স্টোরেজ এবং নেটওয়ার্কিং রিসোর্সের মধ্যে দক্ষ যোগাযোগের উপর নির্ভরশীল, তাই সামগ্রিক এআই প্রশিক্ষণ কর্মক্ষমতা শুধুমাত্র জিপিইউ কর্মক্ষমতার উপর নয়, বরং সম্পূর্ণ অবকাঠামো স্ট্যাকের উপর নির্ভর করে।
| এআই অবকাঠামো উপাদান | এআই প্রশিক্ষণে প্রধান ভূমিকা |
|---|---|
| জিপিইউ | টেন্সর অপারেশন, ম্যাট্রিক্স গুণন এবং ডিপ লার্নিং গণনা ত্বরান্বিত করে। |
| সিপিইউ | ডেটা প্রিপ্রসেসিং, ফিচার ইঞ্জিনিয়ারিং, শিডিউলিং এবং ওয়ার্কলোড অর্কেস্ট্রেশন পরিচালনা করে। |
| জিপিইউ ভিআরএএম | মডেল প্যারামিটার, টেন্সর, গ্র্যাডিয়েন্ট এবং সক্রিয় প্রশিক্ষণ ব্যাচ সংরক্ষণ করে। |
| সিস্টেম র্যাম | ডেটাসেট ক্যাশিং, প্রিপ্রসেসিং পাইপলাইন এবং অপারেটিং সিস্টেম প্রসেসের সহায়তা করে। |
| এন্টারপ্রাইজ এনভিএমই এসএসডি স্টোরেজ | উচ্চ-গতির ডেটাসেট অ্যাক্সেস, চেকপয়েন্ট স্টোরেজ এবং দ্রুত মডেল লোডিং প্রদান করে। |
| উচ্চ-গতির নেটওয়ার্কিং | ডিস্ট্রিবিউটেড ট্রেনিং, মাল্টি-জিপিইউ কমিউনিকেশন এবং জিপিইউ ক্লাস্টার স্কেলেবিলিটি সক্ষম করে। |
জিপিইউ সার্ভারের স্থাপত্যগত সুবিধা আসে এমন বিশেষায়িত হার্ডওয়্যার থেকে যা বিশেষভাবে এআই এবং হাই-পারফরম্যান্স কম্পিউটিংয়ের জন্য ডিজাইন করা হয়েছে। আধুনিক এনভিডিয়া জিপিইউগুলো একত্রিত করে কুডা কোর, টেনসর কোর, হাই-ব্যান্ডউইথ মেমোরি এবং এনভিলিংক, পিসিআইই জেন৫এবং এনভিসুইচ -এর মতো প্রযুক্তিগুলোর সাথে, যা FP16, BF16 এবং TensorFloat অপারেশন ব্যবহার করে মিশ্র-প্রিসিশন ট্রেনিং ত্বরান্বিত করে। এই সক্ষমতাগুলো ট্রেনিং সময় কমায় এবং একইসাথে বড় মডেল, উচ্চতর ব্যাচ সাইজ এবং একাধিক জিপিইউ জুড়ে আরও দক্ষ ডিস্ট্রিবিউটেড এআই ট্রেনিং সম্ভব করে তোলে।
উদাহরণস্বরূপ, একটি Stable Diffusion XL মডেল ট্রেনিং করা বা ওপেন-সোর্স লার্জ ল্যাঙ্গুয়েজ মডেল যেমন Llama, Mistralঅথবা Gemma ফাইন-টিউনিং করা উচ্চ জিপিইউ মেমোরি ব্যান্ডউইথ, এন্টারপ্রাইজ NVMe স্টোরেজ এবং সুষম সিপিইউ পারফরম্যান্স থেকে উল্লেখযোগ্যভাবে উপকৃত হয়। মডেলের জটিলতা বাড়ার সাথে সাথে, বাধাগুলো প্রায়ই জিপিইউ কম্পিউট থেকে স্টোরেজ থ্রুপুট, মেমোরি ব্যান্ডউইথ বা নেটওয়ার্কিং লেটেন্সির দিকে সরে যায়, যা উচ্চ জিপিইউ ব্যবহার বজায় রাখার জন্য ইনফ্রাস্ট্রাকচার ভারসাম্যকে অত্যন্ত গুরুত্বপূর্ণ করে তোলে।
কেন প্রতিষ্ঠানগুলো এআই ট্রেনিংয়ের জন্য জিপিইউ সার্ভার বেছে নেয়
প্রতিষ্ঠানগুলো ডেডিকেটেড জিপিইউ সার্ভারে বিনিয়োগ করে কারণ এটি এআই ডেভেলপমেন্ট জীবনচক্র জুড়ে পরিমাপযোগ্য সুবিধা প্রদান করে।
| সুবিধা | ব্যবসায়িক মূল্য |
|---|---|
| দ্রুততর মডেল ট্রেনিং | প্রশিক্ষণের সময় হ্রাস করে এবং নতুন AI মডেল নিয়ে পরীক্ষা-নিরীক্ষাকে আরও দ্রুত করে তোলে। |
| বৃহত্তর AI মডেলের জন্য সহায়তা | উচ্চতর GPU VRAM বড় ব্যাচ সাইজ, দীর্ঘ কনটেক্সট উইন্ডো এবং আরও জটিল নিউরাল নেটওয়ার্ক ব্যবহার সম্ভব করে তোলে। |
| উন্নত AI ফ্রেমওয়ার্ক সামঞ্জস্যতা | PyTorch, TensorFlow, JAX, CUDA, cuDNN সহ আধুনিক AI ফ্রেমওয়ার্কগুলোর জন্য অপ্টিমাইজড। |
| স্কেলযোগ্য ডিস্ট্রিবিউটেড ট্রেনিং | এন্টারপ্রাইজ AI ওয়ার্কলোডের জন্য মাল্টি-GPU সার্ভার, GPU ক্লাস্টার, NVLink, RDMA এবং InfiniBand সমর্থন করে। |
| উচ্চতর ইনফ্রাস্ট্রাকচার দক্ষতা | সুষম CPU, GPU, মেমরি, স্টোরেজ এবং নেটওয়ার্কিং রিসোর্স ব্যবহারের দক্ষতা বাড়ায় এবং অপারেশনাল বাধা কমায়। |
| দ্রুত প্রোডাকশনে প্রবেশ | প্রোডাকশন AI অ্যাপ্লিকেশনের জন্য দ্রুত মডেল যাচাই, ডিপ্লয়মেন্ট এবং ইনফারেন্স সম্ভব করে তোলে। |
ডেডিকেটেড GPU সার্ভার এমন কিছু সুবিধা প্রদান করে যা ডেস্কটপ ওয়ার্কস্টেশন বা কনজিউমার গেমিং GPU সহজে দিতে পারে না। এন্টারপ্রাইজ GPU ইনফ্রাস্ট্রাকচার তৈরি করা হয় ক্রমাগত পরিচালনা, অনুমানযোগ্য পারফরম্যান্স, মাল্টি-GPU স্কেলেবিলিটি, রিমোট ম্যানেজমেন্ট, এন্টারপ্রাইজ নেটওয়ার্কিং এবং নির্ভরযোগ্য স্টোরেজ বিবেচনায় রেখে, যা একে প্রোডাকশন AI, বৃহৎ ভাষা মডেল প্রশিক্ষণ, বৈজ্ঞানিক গণনা এবং হাই-পারফরম্যান্স কম্পিউটিং (HPC) পরিবেশের জন্য অধিক উপযোগী করে তোলে।
GPU সার্ভার কীভাবে AI ওয়ার্কলোডকে ত্বরান্বিত করে তা বোঝাই সঠিক ইনফ্রাস্ট্রাকচার নির্বাচনের ভিত্তি। পরবর্তী ধাপ হলো GPU আর্কিটেকচার, VRAM ক্ষমতা, CPU পারফরম্যান্স, সিস্টেম মেমরি, স্টোরেজ, নেটওয়ার্কিং, স্কেলেবিলিটি এবং ডিপ্লয়মেন্ট বিকল্পগুলো যাচাই করে দেখা, যাতে আপনার AI প্রশিক্ষণের প্রয়োজনীয়তার সাথে সবচেয়ে উপযুক্ত GPU সার্ভার কনফিগারেশন নির্ধারণ করা যায়।
AI প্রশিক্ষণের জন্য সেরা GPU সার্ভার নির্বাচন
AI প্রশিক্ষণের জন্য সেরা GPU সার্ভার মূলত ব্র্যান্ড নামের ওপর নয়, বরং ওয়ার্কলোডের ধরনের ওপর নির্ভর করে। ভাষা মডেল ফাইন-টিউনিং করা একটি ছোট গবেষণা দল হয়তো GPU VRAM, NVMe SSD ক্ষমতা এবং ঘণ্টাপ্রতি খরচকে অগ্রাধিকার দেবে, আবার মাল্টিমোডাল মডেল প্রশিক্ষণরত কোনো এন্টারপ্রাইজের হয়তো প্রয়োজন হবে মাল্টি-GPU টপোলজি, উচ্চ মেমরি ব্যান্ডউইথ, InfiniBand ফ্যাব্রিক এবং বেয়ার মেটাল আইসোলেশন। সাধারণত সবচেয়ে গুরুত্বপূর্ণ ক্রয়-মানদণ্ডগুলোর মধ্যে থাকে NVIDIA GPU জেনারেশন, CUDA সামঞ্জস্যতা, Tensor Core পারফরম্যান্স, CPU কোর সংখ্যা, RAM ক্ষমতা, স্টোরেজ IOPS, PCIe লেন সহজলভ্যতা এবং প্ল্যাটফর্মটি Docker, Kubernetes এবং সরাসরি ফ্রেমওয়ার্ক ডিপ্লয়মেন্ট সমর্থন করে কিনা।
অনেক ক্রেতার জন্য সিদ্ধান্তটি নির্ভর করে ক্লাউড GPU হোস্টিং বনাম ডেডিকেটেড হার্ডওয়্যারের ওপর। বার্স্ট ওয়ার্কলোড, টেস্টিং, স্বল্পমেয়াদী পরীক্ষা, অথবা সংগ্রহ-প্রক্রিয়ার বিলম্ব ছাড়া তাৎক্ষণিক অ্যাক্সেস প্রয়োজন এমন দলগুলোর জন্য একটি GPU ক্লাউড সার্ভার সাধারণত অধিক উপযোগী। অন্যদিকে একটি ডেডিকেটেড বেয়ার মেটাল সার্ভার সাধারণত স্থিতিশীল প্রশিক্ষণ পাইপলাইন, অনুমানযোগ্য ব্যবহার, কঠোর কমপ্লায়েন্স প্রয়োজনীয়তা এবং উচ্চ GPU ব্যবহারের হার বজায় থাকলে দীর্ঘমেয়াদে কম খরচের জন্য ভালো বিকল্প।
শুধু GPU-এর নামের ওপর ভিত্তি না করে, বরং মডেলের আকার, GPU মেমরির প্রয়োজনীয়তা, ফ্রেমওয়ার্ক সমর্থন, স্টোরেজের গতি, নেটওয়ার্ক ডিজাইন এবং প্রত্যাশিত মাসিক ব্যবহারের ভিত্তিতে AI প্রশিক্ষণ সার্ভার নির্বাচন করুন।
| প্রয়োজনীয়তা | যা অগ্রাধিকার দিতে হবে | সর্বোত্তম উপযুক্ততা |
|---|---|---|
| ছোট মডেল ট্রেনিং | মাঝারি VRAM, কম ঘণ্টাপ্রতি খরচ, সহজ সেটআপ | সিঙ্গেল-জিপিইউ ক্লাউড ইনস্ট্যান্স |
| লার্জ ল্যাঙ্গুয়েজ মডেল | উচ্চ VRAM, NVLink, টেন্সর কোর পারফরম্যান্স, দ্রুতগতির ইন্টারকানেক্ট | মাল্টি-জিপিইউ সার্ভার অথবা জিপিইউ ক্লাস্টার |
| কম্পিউটার ভিশন পাইপলাইন | শক্তিশালী স্টোরেজ IOPS, সুষম CPU ও GPU, বড় লোকাল NVMe | ডেডিকেটেড জিপিইউ সার্ভার |
| ডিস্ট্রিবিউটেড ট্রেনিং | InfiniBand, RDMA, উচ্চ নেটওয়ার্ক থ্রুপুট, অর্কেস্ট্রেশন সাপোর্ট | এআই-এর জন্য জিপিইউ ক্লাস্টার |
| স্বল্পমেয়াদী পরীক্ষা-নিরীক্ষা | অন-ডিমান্ড প্রাইসিং, দ্রুত প্রোভিশনিং, নমনীয় স্কেলিং | ক্লাউডে জিপিইউ সার্ভার হোস্টিং |
খরচ আরেকটি গুরুত্বপূর্ণ বিষয়, যা শুধু জিপিইউর দামের মধ্যেই সীমাবদ্ধ নয়। ক্রেতাদের বিবেচনা করা উচিত ঘণ্টাপ্রতি বা মাসিক জিপিইউ মূল্য, ডেটা ট্রান্সফার চার্জ, CPU ও RAM বরাদ্দ, লোকাল বনাম নেটওয়ার্ক-সংযুক্ত স্টোরেজ, সফটওয়্যার লাইসেন্সিং, এবং অলস রিসোর্সের লুকানো খরচ। যদি মেশিন লার্নিংয়ের জন্য একটি gpu সার্ভার দুর্বল NVMe পারফরম্যান্স বা অপর্যাপ্ত RAM-এর কারণে দীর্ঘ সময় ডেটা লোডিংয়ের জন্য অপেক্ষা করে, তাহলে তালিকাভুক্ত জিপিইউ মূল্য আকর্ষণীয় দেখালেও প্রকৃত ট্রেনিং খরচ বেড়ে যায়। এই কারণেই অবকাঠামো পরিকল্পনায় হার্ডওয়্যার মেট্রিক্স ও ওয়ার্কফ্লো দক্ষতা—উভয়ই অন্তর্ভুক্ত করা উচিত।
- জিপিইউ-সংক্রান্ত খরচ: VRAM-এর আকার, জিপিইউ জেনারেশন, টেন্সর কোর ক্ষমতা, পাওয়ার দক্ষতা
- কম্পিউট খরচ: প্রিপ্রসেসিং, শিডিউলিং এবং ডেটা পাইপলাইনের জন্য CPU কোরের সংখ্যা
- স্টোরেজ খরচ: NVMe SSD ক্ষমতা, স্টোরেজ IOPS, চেকপয়েন্ট ফ্রিকোয়েন্সি, ডেটাসেট ক্যাশিং
- নেটওয়ার্ক খরচ: এগ্রেস ফি, ইন্টার-নোড ব্যান্ডউইথ, RDMA অথবা InfiniBand অ্যাক্সেস
- পরিচালনা ব্যয়: কন্টেইনার অর্কেস্ট্রেশন, মনিটরিং, ব্যাকআপ, নিরাপত্তা নিয়ন্ত্রণ, আপটাইম প্রয়োজনীয়তা
এআই ট্রেনিং এবং মেশিন লার্নিংয়ের জন্য সেরা জিপিইউ সার্ভার কীভাবে নির্বাচন করবেন
এআই ট্রেনিংয়ের জন্য সেরা জিপিইউ সার্ভার নির্বাচন করা মানে শুধু সবচেয়ে শক্তিশালী গ্রাফিক্স কার্ড বেছে নেওয়া নয়। আধুনিক এআই ওয়ার্কলোড একটি সুষম অবকাঠামোর উপর নির্ভর করে, যা জিপিইউ কম্পিউট, ভিআরএএম ক্যাপাসিটি, সিপিইউ পারফরম্যান্স, সিস্টেম মেমরি, এনভিএমই স্টোরেজ, নেটওয়ার্কিং এবং স্কেলেবিলিটিকে একত্রিত করে। এই উপাদানগুলো একসাথে মূল্যায়ন করলে আপনি এমন একটি এআই অবকাঠামো তৈরি করতে পারবেন, যা ধারাবাহিক ট্রেনিং পারফরম্যান্স প্রদান করে, বড় মেশিন লার্নিং মডেলকে সমর্থন করে এবং দীর্ঘমেয়াদী পরিচালন ব্যয় কমিয়ে আনে।
আপনি লার্জ ল্যাঙ্গুয়েজ মডেল (এলএলএম) ট্রেনিং করছেন, ফাউন্ডেশন মডেল ফাইন-টিউন করছেন, কম্পিউটার ভিশন অ্যাপ্লিকেশন তৈরি করছেন, নাকি জেনারেটিভ এআই ডিপ্লয় করছেন—যেটিই হোক না কেন, সঠিক সার্ভার কনফিগারেশন সর্বোচ্চ স্পেসিফিকেশন দেওয়ার পরিবর্তে আপনার ওয়ার্কলোডের সাথে মানানসই হওয়া উচিত।
ধাপ ১: আপনার এআই ওয়ার্কলোড অনুযায়ী জিপিইউ সার্ভার নির্বাচন করুন
প্রতিটি এআই ওয়ার্কলোডের ভিন্ন ভিন্ন হার্ডওয়্যার প্রয়োজনীয়তা থাকে। জিপিইউ মডেল বা সার্ভার প্ল্যান তুলনা করার আগে, আপনি কোন ধরনের মডেল ট্রেনিং করতে চান তা চিহ্নিত করুন। ওয়ার্কলোডের সাথে অবকাঠামো মিলিয়ে নিলে অতিরিক্ত ব্যয় এড়ানো যায় এবং নির্ভরযোগ্য পারফরম্যান্স নিশ্চিত হয়।
| এআই ওয়ার্কলোড | প্রস্তাবিত জিপিইউ সার্ভার কনফিগারেশন |
|---|---|
| এলএলএম ফাইন-টিউনিং | উচ্চ জিপিইউ ভিআরএএম, এন্টারপ্রাইজ এনভিএমই এসএসডি স্টোরেজ, সিইউডিএ-সক্ষম জিপিইউ |
| লার্জ ল্যাঙ্গুয়েজ মডেল (এলএলএম) ট্রেনিং | এনভিলিংক সহ মাল্টি-জিপিইউ সার্ভার, উচ্চ মেমরি ব্যান্ডউইথ এবং দ্রুতগতির নেটওয়ার্কিং |
| স্টেবল ডিফিউশন ও ইমেজ জেনারেশন | উচ্চ ভিআরএএম এবং লো-লেটেন্সি এনভিএমই স্টোরেজ সহ টেনসর কোর জিপিইউ |
| কম্পিউটার ভিশন ও অবজেক্ট ডিটেকশন | সুষম সিপিইউ, জিপিইউ, র্যাম এবং উচ্চ-আইওপিএস স্টোরেজ |
| ভিডিও এআই ও ভিডিও প্রসেসিং | একাধিক জিপিইউ, উচ্চ-কোর সিপিইউ এবং উচ্চ-ব্যান্ডউইথ নেটওয়ার্কিং |
| এআই ইনফারেন্স | লো-লেটেন্সি ইনফারেন্সের জন্য অপ্টিমাইজড শক্তি-সাশ্রয়ী জিপিইউ |
উদাহরণস্বরূপ, একটি ল্যাঙ্গুয়েজ মডেল ফাইন-টিউন করার ক্ষেত্রে মূলত বড় জিপিইউ মেমরি থেকে সুবিধা পাওয়া যায়, অন্যদিকে কম্পিউটার ভিশন ও ভিডিও প্রসেসিং ওয়ার্কলোডের ক্ষেত্রে প্রায়ই ডেটা প্রি-প্রসেসিং দ্রুততর করতে এবং জিপিইউকে পুরোপুরি সক্রিয় রাখতে সুষম সিপিইউ রিসোর্সের প্রয়োজন হয়।
ধাপ ২: জিপিইউ মেমরি (ভিআরএএম) প্রয়োজনীয়তা অনুমান করুন
মেশিন লার্নিং এবং ডিপ লার্নিং মডেল ট্রেনিংয়ের ক্ষেত্রে জিপিইউ মেমরি (ভিআরএএম) প্রায়ই প্রথম সীমাবদ্ধতা হিসেবে কাজ করে। যদি কোনো মডেল উপলব্ধ ভিআরএএম অতিক্রম করে, তাহলে ট্রেনিংয়ের জন্য ছোট ব্যাচ সাইজ, গ্রেডিয়েন্ট চেকপয়েন্টিং, মডেল শার্ডিং অথবা একাধিক জিপিইউর প্রয়োজন হতে পারে—যার সবকটিই ট্রেনিং সময় এবং পরিচালন জটিলতা বাড়িয়ে দিতে পারে।
| মডেলের ধরন | প্রয়োজনীয় সাধারণ জিপিইউ মেমরি |
|---|---|
| ৭বি প্যারামিটার মডেল | ২৪–৪৮ জিবি ভিআরএএম |
| ১৩বি প্যারামিটার মডেল | ৪০–৮০ জিবি ভিআরএএম |
| ৭০বি প্যারামিটার মডেল | এনভিলিংক বা এনভিসুইচসহ একাধিক জিপিইউ |
| স্টেবল ডিফিউশন এক্সএল | ২৪ জিবি বা তার বেশি |
| অবজেক্ট ডিটেকশন ও কম্পিউটার ভিশন মডেল | ১৬–৪৮ জিবি ভিআরএএম |
মডেলের আকার যত বড় হয়, মেমরি ব্যান্ডউইথ, জিপিইউ ইন্টারকানেক্ট এবং ডিস্ট্রিবিউটেড ট্রেনিং সক্ষমতা ততটাই গুরুত্বপূর্ণ হয়ে ওঠে, যতটা গুরুত্বপূর্ণ কাঁচা জিপিইউ কম্পিউট পারফরম্যান্স।
ধাপ ৩: এআই ট্রেনিং এবং মেশিন লার্নিংয়ের জন্য জিপিইউ মডেল তুলনা করুন
সব জিপিইউ একই ধরনের এআই ওয়ার্কলোডের জন্য তৈরি নয়। সঠিক জিপিইউ মডেল বাছাই করা নির্ভর করে মডেলের আকার, জিপিইউ মেমরি (ভিআরএএম), টেনসর কোর পারফরম্যান্স, মেমরি ব্যান্ডউইথ এবং আপনি কী ধরনের মেশিন লার্নিং টাস্ক চালাতে চান—এসব বিষয়ের উপর। আপনার ওয়ার্কলোডের সাথে মানানসই হার্ডওয়্যার বেছে নিলে সাধারণত সর্বশেষ বা সবচেয়ে ব্যয়বহুল জিপিইউ বেছে নেওয়ার চেয়ে ভালো পারফরম্যান্স এবং কম মোট মালিকানা খরচ পাওয়া যায়।
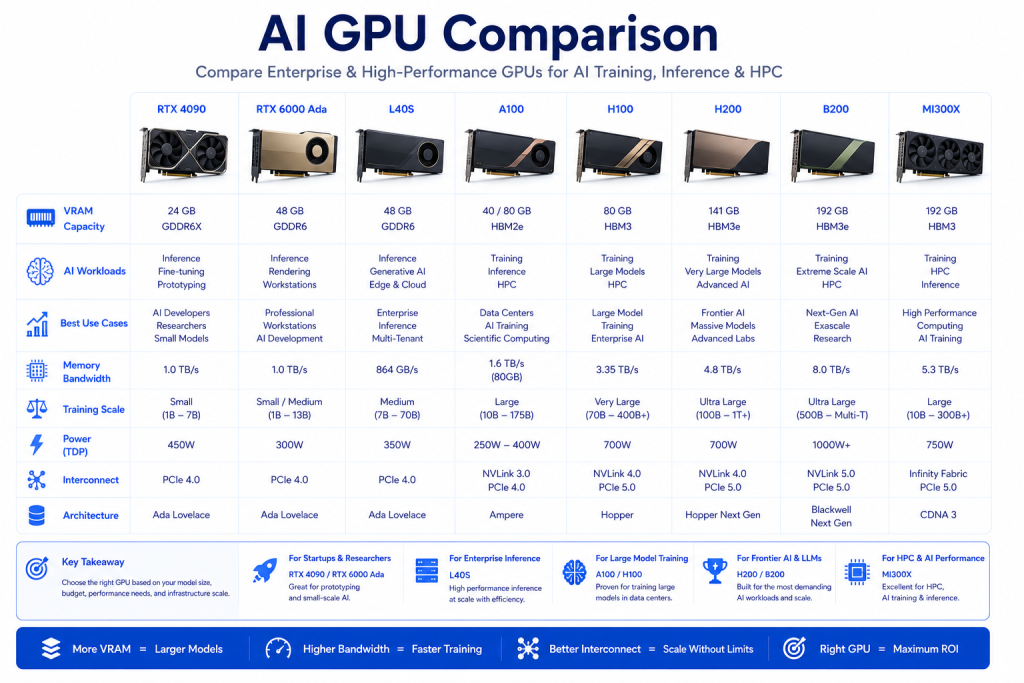
আপনি একটি এআই অ্যাপ্লিকেশন তৈরি করছেন, একটি লার্জ ল্যাঙ্গুয়েজ মডেল (এলএলএম) ফাইন-টিউন করছেন, কম্পিউটার ভিশন মডেল প্রশিক্ষণ দিচ্ছেন, অথবা জেনারেটিভ এআই ওয়ার্কলোড স্থাপন করছেন—যাই হোক না কেন, সার্ভার নির্বাচনের আগে জিপিইউর সক্ষমতা তুলনা করলে আপনার পরিকাঠামো বর্তমান এবং ভবিষ্যৎ উভয় প্রয়োজন পূরণ করতে পারে তা নিশ্চিত করা সহজ হয়।
| জিপিইউ মডেল | ভিআরএএম | যেসব কাজের জন্য সেরা |
|---|---|---|
| এনভিডিয়া আরটিএক্স ৩০৭০ | ৮ জিবি | এআই শেখা, পরীক্ষা-নিরীক্ষা, ছোট মেশিন লার্নিং প্রজেক্ট, প্রাথমিক পর্যায়ের মডেল প্রশিক্ষণ |
| এনভিডিয়া আরটিএক্স ৪০৯০ | ২৪ জিবি | স্টেবল ডিফিউশন, লোরা (LoRA) ট্রেনিং, এলএলএম (LLM) ফাইন-টিউনিং, জেনারেটিভ এআই ডেভেলপমেন্ট |
| NVIDIA RTX 6000 Ada | ৪৮ জিবি | প্রফেশনাল এআই ডেভেলপমেন্ট, এন্টারপ্রাইজ ইনফারেন্স, অ্যাডভান্সড ডিপ লার্নিং ওয়ার্কলোড |
| NVIDIA L40S | ৪৮ জিবি | কম্পিউটার ভিশন, জেনারেটিভ এআই, প্রোডাকশন এআই ইনফারেন্স, মাল্টিমোডাল এআই অ্যাপ্লিকেশন |
| NVIDIA A100 | ৮০ জিবি | এন্টারপ্রাইজ এআই ট্রেনিং, ডিস্ট্রিবিউটেড মেশিন লার্নিং, লার্জ-স্কেল মডেল ডেভেলপমেন্ট |
| NVIDIA H100 | ৮০ জিবি | লার্জ ল্যাঙ্গুয়েজ মডেল (LLM) ট্রেনিং, ফাউন্ডেশন মডেল, হাই-পারফরম্যান্স এআই ক্লাস্টার |
| NVIDIA H200 | ১৪১ জিবি | মেমরি-ইনটেনসিভ এলএলএম, রিট্রিভাল-অগমেন্টেড জেনারেশন (RAG), লার্জ-কনটেক্সট এআই মডেল |
| NVIDIA B200 | ১৮০ জিবি | ফ্রন্টিয়ার এআই ওয়ার্কলোড, নেক্সট-জেনারেশন ফাউন্ডেশন মডেল ট্রেনিং, হাইপারস্কেল এআই ইনফ্রাস্ট্রাকচার |
| AMD Instinct MI300X | ১৯২ জিবি | হাই-পারফরম্যান্স কম্পিউটিং (HPC), এন্টারপ্রাইজ এআই, লার্জ-স্কেল মেশিন লার্নিং, সায়েন্টিফিক কম্পিউটিং |
শুধুমাত্র জিপিইউ মেমরির দিকে মনোযোগ না দিয়ে, সম্পূর্ণ প্ল্যাটফর্মটি তুলনা করুন। CUDA বা ROCm কম্প্যাটিবিলিটি, টেনসর কোর পারফরম্যান্স, মেমরি ব্যান্ডউইথ, PCIe জেনারেশন, NVLink সাপোর্ট, সিপিইউ ব্যালেন্স, NVMe SSD পারফরম্যান্স এবং নেটওয়ার্কিং ক্ষমতা বিবেচনা করুন। একটি সুষম এআই সার্ভার প্রায়শই এমন একটি সার্ভারের তুলনায় ভালো বাস্তবসম্মত ট্রেনিং পারফরম্যান্স প্রদান করে যার জিপিইউ দ্রুততর কিন্তু সহায়ক অবকাঠামো দুর্বল।
এআই মডেলগুলো আকারে ও জটিলতায় ক্রমাগত বৃদ্ধি পাওয়ার সাথে সাথে, প্রতিষ্ঠানগুলোর দীর্ঘমেয়াদী স্কেলেবিলিটিও বিবেচনা করা উচিত। এমন একটি জিপিইউ সার্ভার নির্বাচন করা যা মাল্টি-জিপিইউ এক্সপানশন, অতিরিক্ত মেমরি, হাই-স্পিড স্টোরেজ এবং ভবিষ্যতে জিপিইউ আপগ্রেডকে সমর্থন করে, তা অবকাঠামো খরচ কমাতে সাহায্য করে এবং মেশিন লার্নিং, ডিপ লার্নিং, জেনারেটিভ এআই এবং এন্টারপ্রাইজ এআই ওয়ার্কলোডের জন্য একটি আরও নমনীয় ভিত্তি প্রদান করে।
মূল বিষয়সমূহ
AMD Instinct MI300X HPC, বৈজ্ঞানিক গণনা এবং বৃহৎ পরিসরে AI প্রশিক্ষণের জন্য একটি বিকল্প এন্টারপ্রাইজ প্ল্যাটফর্ম প্রদান করে।
RTX 3070 AI শেখা, পরীক্ষা-নিরীক্ষা এবং হালকা মেশিন লার্নিং প্রকল্পের জন্য উপযুক্ত।
RTX 4090 Stable Diffusion, জেনারেটিভ AI এবং LLM ফাইন-টিউনিংয়ের জন্য চমৎকার মূল্য-পারফরম্যান্স প্রদান করে।
RTX 6000 Ada পেশাদার AI ডেভেলপমেন্ট এবং এন্টারপ্রাইজ ইনফারেন্সের জন্য তৈরি করা হয়েছে।
L40S প্রোডাকশন কম্পিউটার ভিশন এবং মাল্টিমোডাল AI ওয়ার্কলোডের জন্য শক্তিশালী পারফরম্যান্স প্রদান করে।
A100 এন্টারপ্রাইজ AI প্রশিক্ষণ এবং ডিস্ট্রিবিউটেড মেশিন লার্নিংয়ের জন্য একটি প্রমাণিত প্ল্যাটফর্ম হিসেবে রয়ে গেছে।
H100 বৃহৎ পরিসরে বড় ভাষা মডেল এবং ফাউন্ডেশন মডেল প্রশিক্ষণের জন্য আদর্শ।
H200 মেমরি-নিবিড় AI অ্যাপ্লিকেশনের জন্য অপ্টিমাইজ করা হয়েছে, যেগুলোর জন্য বড় কনটেক্সট উইন্ডো প্রয়োজন হয়।
B200 পরবর্তী প্রজন্মের AI ইনফ্রাস্ট্রাকচার এবং ফ্রন্টিয়ার-স্কেল মডেল প্রশিক্ষণকে লক্ষ্য করে তৈরি করা হয়েছে।
আপনার AI ওয়ার্কলোডের জন্য কোন GPU সার্ভার কনফিগারেশনটি সবচেয়ে ভালো?
GPU আর্কিটেকচার এবং হার্ডওয়্যার স্পেসিফিকেশন তুলনা করার পর, পরবর্তী ধাপ হলো এমন একটি GPU সার্ভার কনফিগারেশন নির্বাচন করা যা আপনার AI ওয়ার্কলোডের সাথে সামঞ্জস্যপূর্ণ। সর্বোচ্চ বেঞ্চমার্ক স্কোর বা সবচেয়ে বেশি GPU মেমরি থাকা সার্ভারই সবসময় সেরা GPU সার্ভার হয় না। বরং, সঠিক পছন্দটি নির্ভর করে আপনার মডেলের আকার, প্রশিক্ষণের ফ্রিকোয়েন্সি, ডেটাসেটের জটিলতা, ইনফারেন্স প্রয়োজনীয়তা এবং দীর্ঘমেয়াদী ইনফ্রাস্ট্রাকচার লক্ষ্যের উপর।
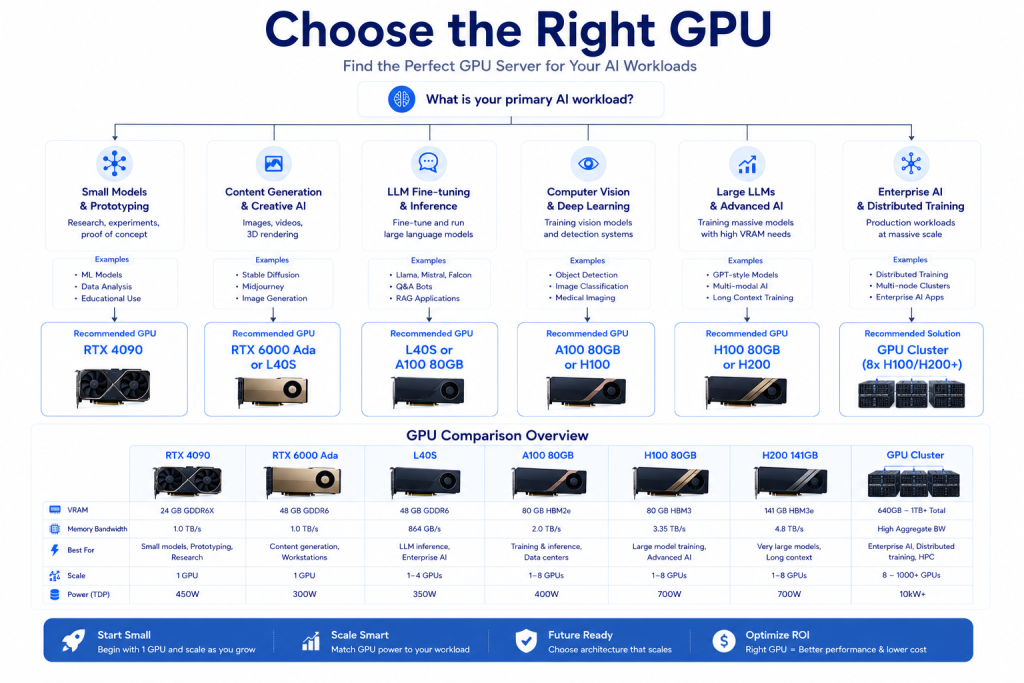
ছোট মেশিন লার্নিং প্রকল্প, গবেষণা পরিবেশ এবং AI পরীক্ষা-নিরীক্ষার জন্য সাধারণত এন্টারপ্রাইজ-স্কেল বড় ভাষা মডেল (LLM) প্রশিক্ষণ বা ডিস্ট্রিবিউটেড ডিপ লার্নিং পাইপলাইনের তুলনায় কম GPU রিসোর্স প্রয়োজন হয়। আপনার ওয়ার্কলোডের সাথে ঘনিষ্ঠভাবে মিলে যায় এমন একটি GPU সার্ভার নির্বাচন করলে রিসোর্স ব্যবহারের দক্ষতা বাড়ে, ইনফ্রাস্ট্রাকচার খরচ কমে এবং আপনার প্রকল্প বৃদ্ধির সাথে সাথে আরও স্কেলযোগ্য AI প্ল্যাটফর্ম তৈরি হয়।
| AI ওয়ার্কলোড | প্রস্তাবিত GPU সার্ভার | কেন এটি সুপারিশ করা হয় |
|---|---|---|
| এআই, পাইথন এবং মেশিন লার্নিং শেখা | RTX 3070 | এআই পরীক্ষা-নিরীক্ষা, মডেল ডেভেলপমেন্ট এবং ছোট মেশিন লার্নিং ওয়ার্কলোডের জন্য সাশ্রয়ী মূল্যের একটি আদর্শ সূচনা বিন্দু। |
| স্টেবল ডিফিউশন, লোরা ট্রেনিং এবং জেনারেটিভ এআই | RTX 4090 | চমৎকার টেনসর কোর পারফরম্যান্স এবং ২৪ জিবি ভিআরএএম এটিকে ইমেজ জেনারেশন এবং আধুনিক এআই মডেল ফাইন-টিউনিংয়ের জন্য আদর্শ করে তোলে। |
| Llama, Mistral, Gemma বা অন্যান্য ওপেন-ওয়েট এলএলএম ফাইন-টিউনিং | RTX 6000 Ada | বড় ভিআরএএম এবং পেশাদার-গ্রেড পারফরম্যান্স কার্যকর ফাইন-টিউনিং এবং উন্নত এআই ডেভেলপমেন্টকে সহায়তা করে। |
| কম্পিউটার ভিশন, মাল্টিমোডাল এআই এবং প্রোডাকশন এআই অ্যাপ্লিকেশন | NVIDIA L40S | এন্টারপ্রাইজ এআই ইনফারেন্স, কম্পিউটার ভিশন, মাল্টিমোডাল এআই এবং প্রোডাকশন মেশিন লার্নিং ওয়ার্কলোডের জন্য অপ্টিমাইজড। |
| এন্টারপ্রাইজ এআই ট্রেনিং এবং ডিস্ট্রিবিউটেড মেশিন লার্নিং | NVIDIA A100 | উচ্চ মেমরি ব্যান্ডউইথ, টেনসর কোর অ্যাকসিলারেশন এবং এনভিলিংক সাপোর্ট এটিকে এন্টারপ্রাইজ-স্কেল এআই ট্রেনিংয়ের জন্য আদর্শ করে তোলে। |
| লার্জ ল্যাঙ্গুয়েজ মডেল (এলএলএম) এবং ফাউন্ডেশন মডেল ট্রেনিং | NVIDIA H100 | বড় আকারের এআই ক্লাস্টার, ফাউন্ডেশন মডেল ট্রেনিং এবং উচ্চ-কর্মক্ষমতাসম্পন্ন ডিস্ট্রিবিউটেড ডিপ লার্নিংয়ের জন্য ডিজাইন করা হয়েছে। |
| লং-কনটেক্সট এলএলএম, রিট্রিভাল-অগমেন্টেড জেনারেশন (RAG) এবং মেমরি-ইনটেনসিভ এআই | NVIDIA H200 | সম্প্রসারিত এইচবিএম মেমরি লং-কনটেক্সট ইনফারেন্স, RAG সিস্টেম এবং মেমরি-ইনটেনসিভ এআই ওয়ার্কলোডের পারফরম্যান্স উন্নত করে। |
| ফ্রন্টিয়ার এআই, হাইপারস্কেল এআই ইনফ্রাস্ট্রাকচার এবং পরবর্তী প্রজন্মের ফাউন্ডেশন মডেল | NVIDIA B200 | হাইপারস্কেল এআই ইনফ্রাস্ট্রাকচার, ফ্রন্টিয়ার মডেল ডেভেলপমেন্ট এবং পরবর্তী প্রজন্মের এন্টারপ্রাইজ এআই ওয়ার্কলোডের জন্য বিশেষভাবে তৈরি। |
| হাই-পারফরম্যান্স কম্পিউটিং (HPC), সায়েন্টিফিক এআই এবং বৃহৎ এন্টারপ্রাইজ এআই প্রকল্প | AMD Instinct MI300X | HPC, বৈজ্ঞানিক কম্পিউটিং এবং এন্টারপ্রাইজ এআই ট্রেনিংয়ের জন্য ব্যতিক্রমী মেমরি ক্ষমতা ও কম্পিউট পারফরম্যান্স প্রদান করে। |
সবচেয়ে ব্যয়বহুল জিপিইউ বেছে নেওয়ার পরিবর্তে, এমন একটি সার্ভার কনফিগারেশন বেছে নিন যা আপনার প্রত্যাশিত ওয়ার্কলোড ও ভবিষ্যৎ প্রবৃদ্ধি পরিকল্পনার সাথে সামঞ্জস্যপূর্ণ। উদাহরণস্বরূপ, যেসব স্টার্টআপ তাদের প্রথম জেনারেটিভ এআই অ্যাপ্লিকেশন তৈরি করছে, তারা প্রায়ই RTX 4090 বা RTX 6000 Ada সার্ভারে ভালো খরচ-দক্ষতা পায়, অন্যদিকে যেসব প্রতিষ্ঠান ক্রমাগত ফাউন্ডেশন মডেল প্রশিক্ষণ দেয়, তাদের জন্য NVIDIA H100, H200, বা B200 প্ল্যাটফর্ম উপযোগী। ব্যবসায়িক প্রয়োজনের সাথে জিপিইউ রিসোর্স মিলিয়ে নেওয়া সাধারণত উচ্চতর জিপিইউ ব্যবহার, দ্রুত প্রশিক্ষণ চক্র এবং শুধুমাত্র বেঞ্চমার্ক পারফরম্যান্সের ভিত্তিতে হার্ডওয়্যার কেনার চেয়ে কম মোট মালিকানার খরচ নিয়ে আসে।
এআই ইনফ্রাস্ট্রাকচার প্রোভাইডার তুলনা করার সময়, শুধু জিপিইউ স্পেসিফিকেশনের বাইরেও বিবেচনা করুন। সম্পূর্ণ প্ল্যাটফর্ম—যেমন সিপিইউ পারফরম্যান্স, সিস্টেম RAM, NVMe SSD স্টোরেজ, নেটওয়ার্কিং, CUDA সামঞ্জস্য, Kubernetes সাপোর্ট, ব্যাকআপ সক্ষমতা, ডেপ্লয়মেন্ট ফ্লেক্সিবিলিটি এবং টেকনিক্যাল সাপোর্ট—বিবেচনায় নিন। যেসব প্রোভাইডারের কাছে বিস্তৃত পরিসরের জিপিইউ সার্ভার কনফিগারেশন রয়েছে—ডেভেলপমেন্ট-কেন্দ্রিক RTX প্ল্যাটফর্ম থেকে শুরু করে এন্টারপ্রাইজ-গ্রেড L40S, A100, H100, H200, B200 এবং AMD Instinct MI300X ইনফ্রাস্ট্রাকচার পর্যন্ত—তাদের ক্ষেত্রে আপনার ইনফ্রাস্ট্রাকচার প্রয়োজনীয়তা বদলে গেলেও ভিন্ন প্ল্যাটফর্মে স্থানান্তর না করেই এআই ওয়ার্কলোড স্কেল করা সহজ হয়।
ধাপ ৪: আপনার জিপিইউ-এর সাথে সিপিইউ পারফরম্যান্স মিলিয়ে নিন
জিপিইউ যখন এআই কম্পিউটেশন সম্পন্ন করে, তখন সিপিইউ পুরো ট্রেনিং পাইপলাইনকে দক্ষতার সাথে সচল রাখে। পর্যাপ্ত সিপিইউ রিসোর্স ছাড়া একটি এআই জিপিইউ সার্ভার বেছে নিলে বটলনেক তৈরি হতে পারে, যার ফলে ব্যয়বহুল জিপিইউগুলো মডেল প্রশিক্ষণের পরিবর্তে ডেটার জন্য অপেক্ষা করতে বাধ্য হয়।
এআই মডেল প্রশিক্ষণের সময় সিপিইউ-এর দায়িত্বে থাকে:
- ডেটা প্রিপ্রসেসিং
- ডেটাসেট লোডিং
- ফিচার এক্সট্র্যাকশন
- ব্যাচ প্রস্তুতি
- ডেটা অগমেন্টেশন
- কন্টেইনার অর্কেস্ট্রেশন
- ডিস্ট্রিবিউটেড টাস্ক শিডিউলিং
- ব্যাকগ্রাউন্ড অপারেটিং সিস্টেম সার্ভিস
উদাহরণস্বরূপ, বৃহৎ কম্পিউটার ভিশন ডেটাসেট প্রশিক্ষণ বা বড় ভাষা মডেল (LLM) ফাইন-টিউন করার ক্ষেত্রে প্রায়শই নিরবচ্ছিন্ন ডেটা স্ট্রিমিংয়ের প্রয়োজন হয়। সিপিইউ যদি পর্যাপ্ত দ্রুততায় ডেটা প্রস্তুত করতে না পারে, তাহলে জিপিইউ ব্যবহারের হার কমে যায়, যার ফলে প্রশিক্ষণের সময় ও ইনফ্রাস্ট্রাকচার খরচ বেড়ে যায়।
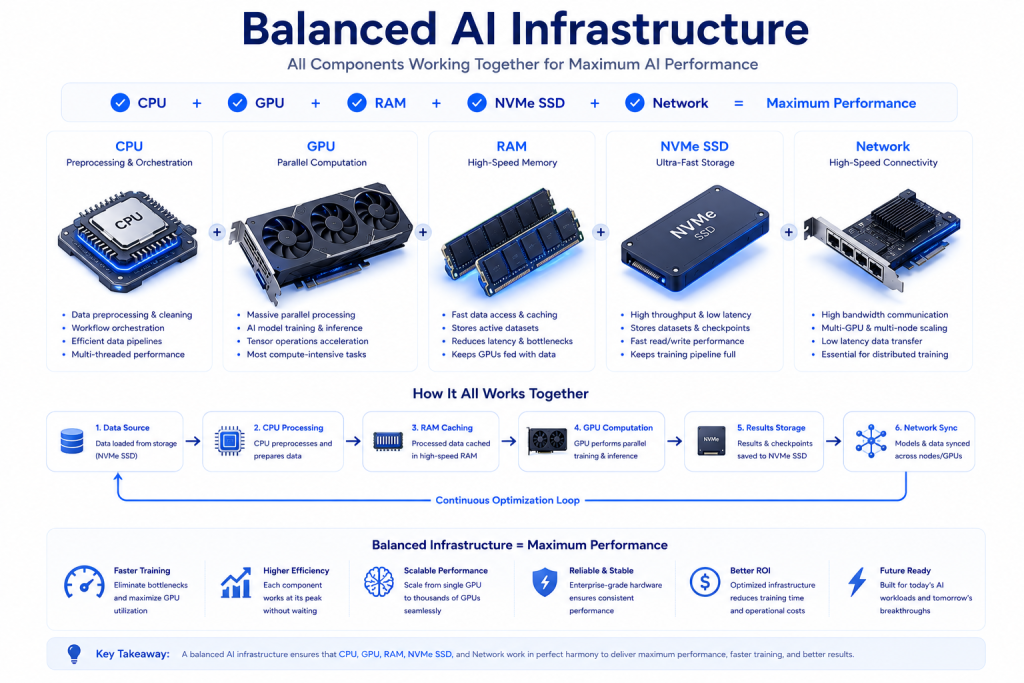
জিপিইউ সার্ভার প্ল্যান তুলনা করার সময়, শুধু সিপিইউ কোরের সংখ্যার বাইরেও বিবেচনা করুন। প্রসেসর জেনারেশন, ক্লক স্পিড, মেমরি ব্যান্ডউইথ, PCIe লেনের প্রাপ্যতা এবং সিপিইউ ও জিপিইউ রিসোর্সের সামগ্রিক ভারসাম্য বিবেচনায় নিন। একটি সুষম সার্ভার পুরো প্রশিক্ষণ প্রক্রিয়া জুড়ে জিপিইউকে সম্পূর্ণ ব্যবহারযোগ্য রাখে।
ধাপ ৫: সিস্টেম RAM এবং জিপিইউ VRAM-এর মধ্যে ভারসাম্য বজায় রাখুন
জিপিইউ VRAM এবং সিস্টেম RAM ভিন্ন ভিন্ন ভূমিকা পালন করে, তবে দক্ষ এআই প্রশিক্ষণের জন্য উভয়ই অপরিহার্য।
| রিসোর্স | মূল উদ্দেশ্য |
|---|---|
| জিপিইউ VRAM | মডেল প্যারামিটার, টেনসর, গ্রেডিয়েন্ট এবং সক্রিয় ট্রেনিং ব্যাচ সংরক্ষণ করে |
| সিস্টেম RAM | ডেটাসেট, প্রিপ্রসেসিং পাইপলাইন, ক্যাশিং, অপারেটিং সিস্টেম প্রসেস এবং ডেটা লোডার ধারণ করে |
অনেক প্রতিষ্ঠান শুধুমাত্র GPU মেমোরির উপর গুরুত্ব দেয়, কিন্তু পর্যাপ্ত সিস্টেম RAM না থাকলে ডেটা লোডিং ধীর হয়ে যেতে পারে, ডিস্ক সোয়াপিং বেড়ে যেতে পারে এবং সামগ্রিক ট্রেনিং থ্রুপুট কমে যেতে পারে। বড় ডেটাসেট, ডিস্ট্রিবিউটেড ট্রেনিং পাইপলাইন বা একাধিক GPU নিয়ে কাজ করার সময় এটি বিশেষভাবে লক্ষণীয় হয়ে ওঠে।
বেশিরভাগ মেশিন লার্নিং ওয়ার্কলোডের ক্ষেত্রে, শুধুমাত্র বড় GPU-তে বিনিয়োগ করার তুলনায় CPU, RAM এবং GPU রিসোর্সের মধ্যে সুষম নির্বাচন করা বাস্তব-জীবনের পারফরম্যান্সে অনেক ভালো ফলাফল দেয়।
ধাপ ৬: হাই-স্পিড NVMe স্টোরেজ নির্বাচন করুন
GPU সার্ভার নির্বাচনের সময় স্টোরেজকে প্রায়শই উপেক্ষা করা হয়, তবে এটি ট্রেনিং দক্ষতাকে সরাসরি প্রভাবিত করে। AI ফ্রেমওয়ার্কগুলো প্রশিক্ষণ জীবনচক্র জুড়ে ক্রমাগত ডেটাসেট পড়ে, চেকপয়েন্ট সংরক্ষণ করে, লগ লেখে এবং প্রিট্রেইনড মডেল লোড করে।
AI GPU সার্ভার মূল্যায়নের সময়, নিম্নলিখিত বিষয়গুলোকে অগ্রাধিকার দিন:
- এন্টারপ্রাইজ NVMe SSD স্টোরেজ
- উচ্চ রিড এবং রাইট IOPS
- উন্নত নির্ভরযোগ্যতার জন্য RAID রিডানডেন্সি
- ডেডিকেটেড চেকপয়েন্ট স্টোরেজ
- দ্রুত ডেটাসেট অ্যাক্সেস
- স্ন্যাপশট এবং ব্যাকআপ সুবিধা
- ক্রমবর্ধমান AI ডেটাসেটের জন্য স্কেলযোগ্য স্টোরেজ
SATA SSD বা HDD-ভিত্তিক স্টোরেজের তুলনায়, এন্টারপ্রাইজ NVMe ড্রাইভ ডেটাসেট লোডিং সময় এবং চেকপয়েন্ট ল্যাটেন্সি উল্লেখযোগ্যভাবে কমিয়ে দেয়, ফলে GPU স্টোরেজ অপারেশনের জন্য অপেক্ষা না করে বেশি সময় ট্রেনিংয়ে ব্যয় করতে পারে।
ধাপ ৭: নেটওয়ার্ক পারফরম্যান্স মূল্যায়ন করুন
AI ইনফ্রাস্ট্রাকচার একটি একক GPU-এর বাইরে বিস্তৃত হওয়ার সাথে সাথে, সামগ্রিক ট্রেনিং গতির ক্ষেত্রে নেটওয়ার্ক পারফরম্যান্স একটি গুরুত্বপূর্ণ বিষয় হয়ে ওঠে।
ডিস্ট্রিবিউটেড ট্রেনিং, মাল্টি-GPU সিঙ্ক্রোনাইজেশন এবং মাল্টি-নোড AI ক্লাস্টারগুলো গ্রেডিয়েন্ট এবং মডেল আপডেট দক্ষতার সাথে বিনিময় করার জন্য লো-ল্যাটেন্সি, হাই-ব্যান্ডউইথ নেটওয়ার্কিংয়ের উপর নির্ভর করে।
নিম্নলিখিত নেটওয়ার্কিং অপশনগুলো বিবেচনা করুন:
| নেটওয়ার্ক স্পিড | প্রস্তাবিত ব্যবহারের ক্ষেত্র |
|---|---|
| ১০ Gbps | ডেভেলপমেন্ট এনভায়রনমেন্ট এবং ছোট AI টিম |
| ২৫ Gbps | মাল্টি-GPU ট্রেনিং এবং ক্রমবর্ধমান মেশিন লার্নিং ওয়ার্কলোড |
| ১০০ Gbps | এন্টারপ্রাইজ AI ক্লাস্টার এবং বৃহৎ-স্কেল ডিস্ট্রিবিউটেড ট্রেনিং |
| InfiniBand / RDMA | হাই-পারফরম্যান্স কম্পিউটিং (HPC) এবং লো-লেটেন্সি GPU কমিউনিকেশন |
যেসব প্রতিষ্ঠান বড় ল্যাঙ্গুয়েজ মডেল ট্রেনিং করে অথবা একাধিক GPU সার্ভার পরিচালনা করে, তাদের জন্য দ্রুতগতির নেটওয়ার্কিং কমিউনিকেশন ওভারহেড কমিয়ে ডিস্ট্রিবিউটেড ট্রেনিংয়ের কার্যকারিতা বৃদ্ধি করে।
ধাপ ৮: ভবিষ্যৎ স্কেলেবিলিটি বিবেচনা করুন
AI ইনফ্রাস্ট্রাকচারের চাহিদা প্রায়শই প্রত্যাশার চেয়েও দ্রুত বৃদ্ধি পায়। যে GPU সার্ভার আজকের ওয়ার্কলোডের জন্য ভালো কাজ করছে, তা মডেলের আকার, ডেটাসেট এবং ট্রেনিং ফ্রিকোয়েন্সি বাড়ার সাথে সাথে একটি সীমাবদ্ধতায় পরিণত হতে পারে। AI ট্রেনিংয়ের জন্য স্কেলেবল একটি GPU সার্ভার বেছে নেওয়া আপনার মেশিন লার্নিং ইনফ্রাস্ট্রাকচার বিকশিত হওয়ার সাথে সাথে ব্যয়বহুল হার্ডওয়্যার প্রতিস্থাপন, জটিল মাইগ্রেশন এবং অপ্রয়োজনীয় ডাউনটাইম এড়াতে সাহায্য করে।
ক্রমবর্ধমান AI স্টার্টআপ বা এন্টারপ্রাইজ পরিবেশের জন্য একটি GPU সার্ভার মূল্যায়ন করার সময়, প্ল্যাটফর্মটি ভবিষ্যৎ সম্প্রসারণকে সমর্থন করে কিনা তা বিবেচনা করুন। মাল্টি-GPU কনফিগারেশন, NVLink বা হাই-স্পিড GPU ইন্টারকানেক্ট, PCIe Gen5 এক্সপ্যানশন স্লট, অতিরিক্ত NVMe SSD ক্যাপাসিটি এবং মেমোরি আপগ্রেডের সাপোর্ট আছে কিনা তা দেখুন, যা বড় ডেটাসেট ও আরও চাহিদাসম্পন্ন AI মডেল পরিচালনা সম্ভব করে। যদি আপনার পরিকল্পনায় ডিস্ট্রিবিউটেড মেশিন লার্নিং বা লার্জ ল্যাঙ্গুয়েজ মডেল (LLM) ট্রেনিং অন্তর্ভুক্ত থাকে, তাহলে নিশ্চিত করুন যে আপনার ইনফ্রাস্ট্রাকচার সম্পূর্ণ প্ল্যাটফর্ম পুনর্গঠন ছাড়াই Kubernetes, GPU ক্লাস্টার, বা নিবেদিত বেয়ার মেটাল GPU ক্লাস্টারের সাথে ইন্টিগ্রেট হতে পারে।
একটি স্কেলেবল AI সার্ভারের উচিত ঘন ঘন ইনফ্রাস্ট্রাকচার পরিবর্তনের প্রয়োজন না করে আপনার ওয়ার্কলোডের সাথে সাথে বৃদ্ধি পাওয়া। নমনীয় স্টোরেজ, নেটওয়ার্কিং এবং কম্পিউট রিসোর্সসহ সম্প্রসারণযোগ্য GPU সার্ভারে বিনিয়োগ করলে প্রতিষ্ঠানগুলো বড় ফাউন্ডেশন মডেল, ডিস্ট্রিবিউটেড AI ট্রেনিং এবং ভবিষ্যৎ মেশিন লার্নিং প্রকল্পগুলো সমর্থন করতে পারে, সেই সাথে দীর্ঘমেয়াদী ইনফ্রাস্ট্রাকচার খরচ পূর্বানুমানযোগ্য রাখতে পারে।
ধাপ ৯: AI ট্রেনিং ও মেশিন লার্নিংয়ের জন্য সঠিক GPU ডিপ্লয়মেন্ট মডেল বেছে নিন
সঠিক GPU ডিপ্লয়মেন্ট মডেল নির্বাচন করা সঠিক GPU হার্ডওয়্যার নির্বাচনের মতোই গুরুত্বপূর্ণ। যদিও GPU আর্কিটেকচার, VRAM ক্যাপাসিটি এবং Tensor Core পারফরম্যান্স AI ট্রেনিংয়ের গতিকে প্রভাবিত করে, ডিপ্লয়মেন্ট মডেলই নির্ধারণ করে আপনার ইনফ্রাস্ট্রাকচার কতটা কার্যকরভাবে স্কেল করে, ওয়ার্কলোডগুলো কতটা নিরাপদভাবে আইসোলেট করা হয়, এবং আপনার টিম পরিবেশের উপর কতটা অপারেশনাল নিয়ন্ত্রণ বজায় রাখে।
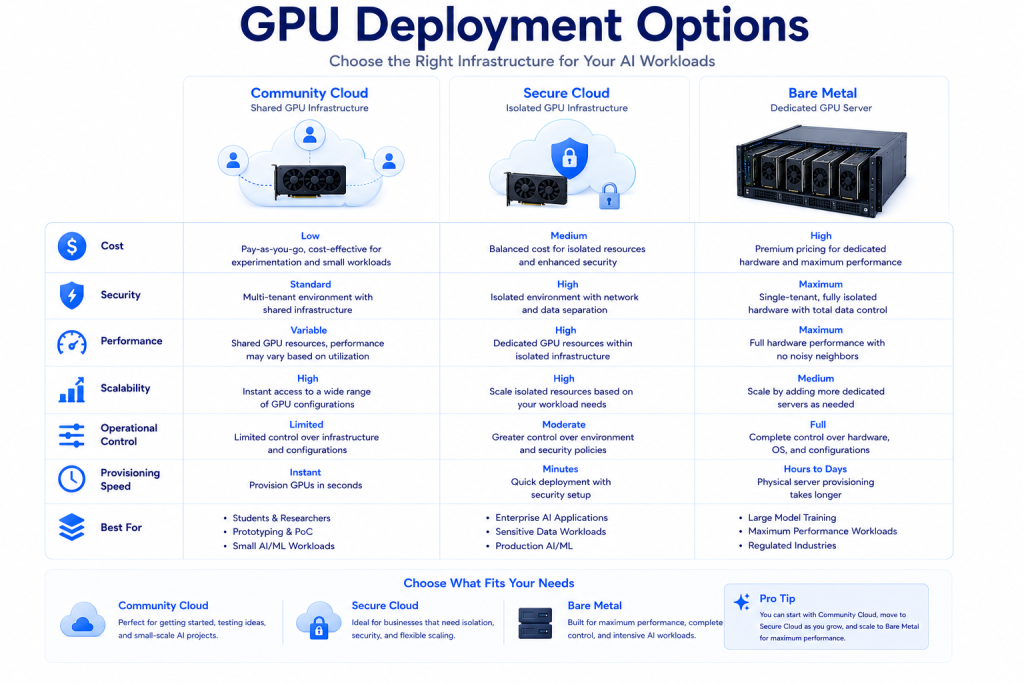
সবচেয়ে উপযুক্ত ডিপ্লয়মেন্ট মডেল বেশ কয়েকটি বিষয়ের উপর নির্ভর করে, যেমন ওয়ার্কলোডের স্থায়িত্ব, GPU ব্যবহারের হার, নিরাপত্তার প্রয়োজনীয়তা, কমপ্লায়েন্স বাধ্যবাধকতা, ইনফ্রাস্ট্রাকচার ম্যানেজমেন্টের পছন্দ এবং দীর্ঘমেয়াদী AI প্রবৃদ্ধির পরিকল্পনা। ক্লাউড নাকি বেয়ার মেটাল স্বভাবতই ভালো—এই প্রশ্ন করার পরিবর্তে, কোন পরিবেশ আপনার বর্তমান মেশিন লার্নিং ওয়ার্কফ্লোকে সবচেয়ে ভালোভাবে সমর্থন করে এবং ভবিষ্যৎ সম্প্রসারণের জন্য নমনীয়তা প্রদান করে তা মূল্যায়ন করুন।
| GPU ডিপ্লয়মেন্ট মডেল | সাধারণ ওয়ার্কলোড | প্রধান সুবিধাসমূহ |
|---|---|---|
| কমিউনিটি GPU ক্লাউড | AI শিক্ষা, মেশিন লার্নিং পরীক্ষণ-নিরীক্ষণ, প্রুফ-অফ-কনসেপ্ট প্রকল্প, একাডেমিক গবেষণা, মডেল প্রোটোটাইপিং এবং স্বল্পমেয়াদী GPU ওয়ার্কলোড | দ্রুত প্রভিশনিং, নমনীয় রিসোর্স বরাদ্দ, কম ইনফ্রাস্ট্রাকচার খরচ, এবং নিবেদিত হার্ডওয়্যার প্রতিশ্রুতি ছাড়াই GPU কম্পিউটিংয়ে দ্রুত প্রবেশাধিকার। |
| সিকিউর GPU ক্লাউড | প্রোডাকশন AI অ্যাপ্লিকেশন, কাস্টমার-ফেসিং ইনফারেন্স সার্ভিস, এন্টারপ্রাইজ মেশিন লার্নিং, রিট্রিভাল-অগমেন্টেড জেনারেশন (RAG), নিয়ন্ত্রিত পরিবেশ, এবং স্পর্শকাতর ব্যবসায়িক ডেটা | আইসোলেটেড GPU রিসোর্স, এন্টারপ্রাইজ-গ্রেড নিরাপত্তা, পূর্বানুমানযোগ্য পারফরম্যান্স, স্কেলেবল ক্লাউড ইনফ্রাস্ট্রাকচার এবং উন্নত ওয়ার্কলোড নির্ভরযোগ্যতা। |
| বেয়ার মেটাল GPU সার্ভার | ক্রমাগত এআই প্রশিক্ষণ, ডিস্ট্রিবিউটেড ডিপ লার্নিং, ফাউন্ডেশন মডেল ডেভেলপমেন্ট, মাল্টি-জিপিইউ ক্লাস্টার, লার্জ ল্যাঙ্গুয়েজ মডেল (LLM) প্রশিক্ষণ, এবং হাই-পারফরম্যান্স কম্পিউটিং (HPC) | ডেডিকেটেড জিপিইউ রিসোর্স, পূর্বানুমানযোগ্য লেটেন্সি, সর্বোচ্চ হার্ডওয়্যার পারফরম্যান্স, সম্পূর্ণ ইনফ্রাস্ট্রাকচার নিয়ন্ত্রণ, এবং দীর্ঘমেয়াদী এআই ওয়ার্কলোডের জন্য সামঞ্জস্যপূর্ণ পারফরম্যান্স। |
প্রতিটি ডিপ্লয়মেন্ট মডেল কোথায় মানানসই তা বোঝা
কমিউনিটি জিপিইউ ক্লাউড ডেভেলপার, গবেষক, স্টার্টআপ এবং শিক্ষার্থীদের জন্য একটি সহজলভ্য পরিবেশ প্রদান করে যারা কৃত্রিম বুদ্ধিমত্তা নিয়ে গবেষণা করছেন। এটি সাধারণত ছোট মেশিন লার্নিং মডেল প্রশিক্ষণ, PyTorch, TensorFlow এবং JAX-এর মতো ফ্রেমওয়ার্ক নিয়ে পরীক্ষা-নিরীক্ষা, Stable Diffusion ওয়ার্কফ্লো তৈরি, নতুন এআই ধারণা যাচাই এবং প্রোডাকশনে যাওয়ার আগে ইনফ্রাস্ট্রাকচার পরীক্ষা করার জন্য ব্যবহৃত হয়। যেহেতু রিসোর্স দ্রুত প্রভিশন করা যায়, তাই এই মডেলটি ডেডিকেটেড হার্ডওয়্যার পরিচালনার জটিলতা ছাড়াই দ্রুত পরীক্ষা-নিরীক্ষার সুযোগ দেয়।
সিকিউর জিপিইউ ক্লাউড এমন প্রোডাকশন এআই পরিবেশকে সহায়তা করে যেখানে ইনফ্রাস্ট্রাকচার নিরাপত্তা, ওয়ার্কলোড আইসোলেশন এবং সার্ভিস নির্ভরযোগ্যতা পরিচালনাগত অগ্রাধিকার হয়ে ওঠে। যেসব প্রতিষ্ঠান এআই SaaS প্ল্যাটফর্ম, গ্রাহক-মুখী ইনফারেন্স API, রিট্রিভাল-অগমেন্টেড জেনারেশন (RAG) সিস্টেম, অথবা গোপনীয় তথ্য প্রক্রিয়াকরণকারী ব্যবসায়িক অ্যাপ্লিকেশন ডিপ্লয় করে, তাদের সাধারণত শক্তিশালী রিসোর্স আইসোলেশন এবং এন্টারপ্রাইজ-গ্রেড ক্লাউড ইনফ্রাস্ট্রাকচারের প্রয়োজন হয়। এই ডিপ্লয়মেন্ট মডেলটি পরিচালনাগত নমনীয়তাকে প্রোডাকশন এআই সার্ভিসের জন্য প্রত্যাশিত নিরাপত্তা ও availability-এর সাথে ভারসাম্যপূর্ণ করে।
বেয়ার মেটাল জিপিইউ সার্ভার সেইসব প্রতিষ্ঠানের জন্য তৈরি করা হয়েছে যাদের এআই প্রশিক্ষণ, ডিস্ট্রিবিউটেড মেশিন লার্নিং, ফাউন্ডেশন মডেল ডেভেলপমেন্ট এবং এন্টারপ্রাইজ-স্কেল ডিপ লার্নিংয়ের জন্য ডেডিকেটেড জিপিইউ রিসোর্সের নিরবচ্ছিন্ন অ্যাক্সেস প্রয়োজন। যেহেতু কম্পিউট, স্টোরেজ এবং নেটওয়ার্কিং রিসোর্স অন্য কোনো টেন্যান্টের সাথে শেয়ার করা হয় না, তাই বেয়ার মেটাল ইনফ্রাস্ট্রাকচার পূর্বানুমানযোগ্য পারফরম্যান্স, সামঞ্জস্যপূর্ণ জিপিইউ ব্যবহার এবং অপারেটিং সিস্টেম, জিপিইউ ড্রাইভার, CUDA পরিবেশ, নেটওয়ার্কিং এবং স্টোরেজ কনফিগারেশনের উপর সম্পূর্ণ নিয়ন্ত্রণ প্রদান করে। এই বৈশিষ্ট্যগুলো ডেডিকেটেড জিপিইউ সার্ভারকে লার্জ ল্যাঙ্গুয়েজ মডেল (LLM) প্রশিক্ষণ, মাল্টি-জিপিইউ ক্লাস্টার, জেনারেটিভ এআই প্ল্যাটফর্ম, বৈজ্ঞানিক কম্পিউটিং এবং হাই-পারফরম্যান্স কম্পিউটিং (HPC) ওয়ার্কলোডের জন্য উপযুক্ত করে তোলে।
উপযুক্ত ডিপ্লয়মেন্ট মডেল নির্বাচন করার ক্ষেত্রে শুধুমাত্র ঘণ্টাভিত্তিক মূল্য বা হার্ডওয়্যার স্পেসিফিকেশন তুলনা করাই যথেষ্ট নয়। প্রতিষ্ঠানগুলোর উচিত জিপিইউ availability, সিপিইউ পারফরম্যান্স, সিস্টেম মেমরি, এন্টারপ্রাইজ NVMe SSD স্টোরেজ, নেটওয়ার্কিং ব্যান্ডউইথ, Kubernetes সামঞ্জস্যতা, ব্যাকআপ ও ডিজাস্টার রিকভারি সক্ষমতা, ইনফ্রাস্ট্রাকচার স্কেলেবিলিটি এবং টেকনিক্যাল সাপোর্ট মূল্যায়ন করা। যেসব প্রোভাইডার একই প্ল্যাটফর্মের মধ্যে কমিউনিটি জিপিইউ ক্লাউড, সিকিউর জিপিইউ ক্লাউড এবং বেয়ার মেটাল জিপিইউ সার্ভার সরবরাহ করে, তারা এআই দলগুলোকে তাদের ইনফ্রাস্ট্রাকচার পুনর্গঠন বা ভিন্ন প্রোভাইডারে স্থানান্তরিত না হয়েই পরীক্ষা-নিরীক্ষা থেকে প্রোডাকশনে এবং পরবর্তীতে এন্টারপ্রাইজ-স্কেল এআই প্রশিক্ষণে রূপান্তরিত হতে সক্ষম করে।
এআই প্রশিক্ষণের জন্য জিপিইউ সার্ভার সেটআপ ও অপ্টিমাইজ করা
এআই প্রশিক্ষণের জন্য একটি জিপিইউ সার্ভার ডিপ্লয় করা শুধুমাত্র NVIDIA ড্রাইভার এবং মেশিন লার্নিং ফ্রেমওয়ার্ক ইনস্টল করার চেয়ে অনেক বেশি কিছু জড়িত। একটি প্রোডাকশন-প্রস্তুত এআই পরিবেশের জন্য প্রয়োজন একটি সুষম সফটওয়্যার ও ইনফ্রাস্ট্রাকচার স্ট্যাক, যা অপারেটিং সিস্টেম স্থিতিশীলতা, জিপিইউ অ্যাক্সিলারেশন লাইব্রেরি, কনটেইনারাইজেশন, উচ্চগতির স্টোরেজ, মনিটরিং এবং নিরাপত্তাকে একত্রিত করে। এই ভিত্তি সঠিকভাবে তৈরি করা reproducibility উন্নত করে, এআই দলগুলোর মধ্যে সহযোগিতা সহজ করে এবং মেশিন লার্নিং লাইফসাইকেল জুড়ে সামঞ্জস্যপূর্ণ পারফরম্যান্স প্রদান করে।
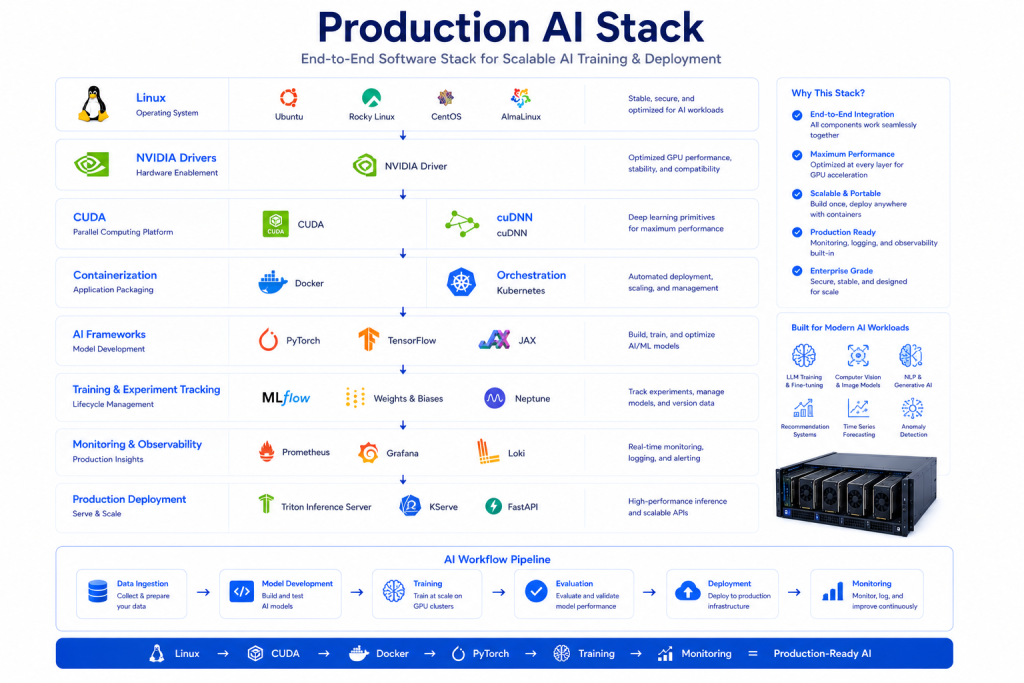
বেশিরভাগ এআই প্রশিক্ষণ পরিবেশ Linux-এর উপর তৈরি করা হয়, কারণ এটি NVIDIA জিপিইউ ড্রাইভার, CUDA, cuDNN, Docker, Kubernetes এবং শীর্ষস্থানীয় এআই ফ্রেমওয়ার্কের সাথে ব্যাপক সামঞ্জস্যতা প্রদান করে, যেমন PyTorch, TensorFlow, JAX, Hugging Face Transformers, এবং vLLM। সফটওয়্যার স্ট্যাক স্ট্যান্ডার্ডাইজ করা ডিপেন্ডেন্সি কনফ্লিক্ট কমাতে সাহায্য করে এবং নিশ্চিত করে যে ওয়ার্কলোডগুলো ডেভেলপমেন্ট, টেস্টিং, স্টেজিং এবং প্রোডাকশন পরিবেশ জুড়ে পোর্টেবল থাকে।
মূল সফটওয়্যার ও ইনফ্রাস্ট্রাকচার কম্পোনেন্ট
একটি প্রোডাকশন AI ট্রেনিং প্ল্যাটফর্ম একাধিক ইনফ্রাস্ট্রাকচার স্তরকে একত্রিত করে কাজ করে, যা GPU ব্যবহারের হার এবং ট্রেনিং দক্ষতা সর্বোচ্চ পর্যায়ে নিয়ে যেতে একসঙ্গে কাজ করে।
| ইনফ্রাস্ট্রাকচার উপাদান | মূল উদ্দেশ্য |
|---|---|
| অপারেটিং সিস্টেম | Ubuntu অথবা অন্য কোনো এন্টারপ্রাইজ Linux ডিস্ট্রিবিউশন, যা একটি স্থিতিশীল AI ডেভেলপমেন্ট পরিবেশ প্রদান করে। |
| GPU ড্রাইভার | অপারেটিং সিস্টেম এবং NVIDIA GPU হার্ডওয়্যারের মধ্যে যোগাযোগ সক্ষম করে। |
| CUDA ও cuDNN | বিভিন্ন AI ফ্রেমওয়ার্ক জুড়ে টেনসর অপারেশন এবং ডিপ লার্নিং ওয়ার্কলোডকে গতিশীল করে। |
| AI ফ্রেমওয়ার্ক | মডেল ট্রেনিং এবং ইনফারেন্সের জন্য PyTorch, TensorFlow, JAX, Hugging Face Transformers এবং vLLM। |
| কন্টেইনার প্ল্যাটফর্ম | পুনরুৎপাদনযোগ্য ডিপ্লয়মেন্ট এবং ওয়ার্কলোড অর্কেস্ট্রেশনের জন্য Docker এবং Kubernetes। |
| এন্টারপ্রাইজ NVMe SSD স্টোরেজ | উচ্চ গতির ডেটাসেট লোডিং, চেকপয়েন্ট স্টোরেজ এবং মডেল আর্টিফ্যাক্ট ব্যবস্থাপনা। |
| মনিটরিং ও অবজার্ভেবিলিটি | GPU ব্যবহারের হার, CPU ব্যবহার, VRAM, স্টোরেজ I/O, নেটওয়ার্কিং এবং সিস্টেম স্বাস্থ্য পর্যবেক্ষণ। |
| সিকিউরিটি ও অ্যাক্সেস কন্ট্রোল | SSH হার্ডেনিং, সিক্রেটস ম্যানেজমেন্ট, রোল-বেসড অ্যাক্সেস কন্ট্রোল (RBAC), এবং সফটওয়্যার লাইফসাইকেল ম্যানেজমেন্ট। |
প্রস্তাবিত GPU সার্ভার ডিপ্লয়মেন্ট ওয়ার্কফ্লো
একটি নির্ভরযোগ্য AI ট্রেনিং পরিবেশ তৈরি করার জন্য একটি সুগঠিত ডিপ্লয়মেন্ট প্রক্রিয়া অনুসরণ করা হয়, যা কনফিগারেশন সংক্রান্ত সমস্যা কমিয়ে আনে এবং দীর্ঘমেয়াদী রক্ষণাবেক্ষণযোগ্যতা উন্নত করে।
| ডিপ্লয়মেন্ট স্টেজ | উদ্দেশ্য |
|---|---|
| ইনফ্রাস্ট্রাকচার প্রভিশনিং | কর্মভার (workload) এর প্রয়োজনীয়তা অনুযায়ী উপযুক্ত GPU, CPU, সিস্টেম RAM, এন্টারপ্রাইজ NVMe SSD স্টোরেজ এবং নেটওয়ার্কিং কনফিগারেশন নির্বাচন করুন। |
| অপারেটিং সিস্টেম কনফিগারেশন | Linux ইনস্টল করুন, সিকিউরিটি আপডেট প্রয়োগ করুন এবং বেস অপারেটিং এনভায়রনমেন্ট প্রস্তুত করুন। |
| GPU সক্রিয়করণ | নির্বাচিত AI ফ্রেমওয়ার্কের সাথে সামঞ্জস্যপূর্ণ NVIDIA ড্রাইভার, CUDA Toolkit এবং cuDNN সংস্করণ ইনস্টল করুন। |
| AI ফ্রেমওয়ার্ক কনফিগারেশন | PyTorch, TensorFlow, JAX, Hugging Face লাইব্রেরি, অথবা অন্যান্য প্রয়োজনীয় AI সফটওয়্যার ডিপ্লয় করুন। |
| কন্টেইনারাইজেশন ও অর্কেস্ট্রেশন | যেখানে পুনরুৎপাদনযোগ্য ডিপ্লয়মেন্ট বা মাল্টি-ইউজার এনভায়রনমেন্ট প্রয়োজন, সেখানে Docker কন্টেইনার এবং Kubernetes কনফিগার করুন। |
| স্টোরেজ কনফিগারেশন | সর্বোচ্চ থ্রুপুটের জন্য ডেটাসেট, মডেল চেকপয়েন্ট এবং ট্রেনিং আর্টিফ্যাক্ট এন্টারপ্রাইজ NVMe SSD স্টোরেজে রাখুন। |
| ভ্যালিডেশন ও বেঞ্চমার্কিং | এই কমান্ডের মাধ্যমে GPU শনাক্তকরণ যাচাই করুন: nvidia-smi, GPU ব্যবহারের হার বেঞ্চমার্ক করুন, CUDA সামঞ্জস্যতা যাচাই করুন এবং স্টোরেজ ও নেটওয়ার্ক পারফরম্যান্স পরিমাপ করুন। |
প্রোডাকশন ট্রেনিং শুরু হওয়ার আগে, সম্পূর্ণ হার্ডওয়্যার এবং সফটওয়্যার স্ট্যাক যাচাই করুন। বড় আকারের মডেল ট্রেনিংকে প্রভাবিত করার আগেই কনফিগারেশন সমস্যা চিহ্নিত করতে GPU শনাক্তকরণ, CUDA সামঞ্জস্যতা, স্টোরেজ থ্রুপুট, নেটওয়ার্কিং পারফরম্যান্স এবং AI ফ্রেমওয়ার্কের কার্যকারিতা নিশ্চিত করুন।
শুধু GPU নয়, সম্পূর্ণ ডেটা পাইপলাইন অপ্টিমাইজ করুন
অনেক প্রতিষ্ঠান শক্তিশালী GPU-তে বিনিয়োগ করে, কিন্তু সেগুলোকে ব্যস্ত রাখা ডেটা পাইপলাইনের দিকে নজর দেয় না। বাস্তবে, ধীরগতির ডেটাসেট লোডিং, অপর্যাপ্ত CPU রিসোর্স, স্টোরেজ বটলনেক, অথবা অদক্ষ ডেটালোডার GPU কম ব্যবহৃত হওয়ার সবচেয়ে সাধারণ কারণগুলোর মধ্যে অন্যতম।
সামঞ্জস্যপূর্ণ AI ট্রেনিং পারফরম্যান্সের জন্য:
- সক্রিয় ডেটাসেট এবং মডেল চেকপয়েন্ট এন্টারপ্রাইজ NVMe SSD স্টোরেজে সংরক্ষণ করুন।
- উপলব্ধ CPU কোরের সাথে ডেটালোডার ওয়ার্কারের সংখ্যা মিলিয়ে নিন।
- যেখানে সমর্থিত, সেখানে FP16 বা BF16 ব্যবহার করে মিক্সড-প্রিসিশন ট্রেনিং সক্রিয় করুন।
- ট্রেনিং চলাকালীন সময় GPU ব্যবহারের হার এবং VRAM ব্যবহার পর্যবেক্ষণ করুন।
- উপলব্ধ GPU মেমরি এবং সিস্টেম RAM-এর সাথে ব্যাচ সাইজের ভারসাম্য বজায় রাখুন।
- ইনপুট বটলনেক দূর করতে স্টোরেজ থ্রুপুট বেঞ্চমার্ক করুন।
শুধুমাত্র জিপিউ হার্ডওয়্যার আপগ্রেড করার চেয়ে সম্পূর্ণ ট্রেনিং পাইপলাইন অপ্টিমাইজ করলে প্রায়ই অনেক বেশি পারফরম্যান্স উন্নতি পাওয়া যায়।
রিপ্রোডিউসিবল এআই ট্রেনিং ওয়ার্কফ্লো তৈরি করুন
এআই ইনফ্রাস্ট্রাকচার যত বৃদ্ধি পায়, সহযোগিতা, স্কেলেবিলিটি এবং অপারেশনাল সামঞ্জস্যের জন্য রিপ্রোডিউসিবিলিটি অপরিহার্য হয়ে ওঠে। কন্টেইনারাইজড এনভায়রনমেন্ট ডেটা সায়েন্টিস্ট, মেশিন লার্নিং ইঞ্জিনিয়ার এবং ডেভঅপস টিমগুলোকে একাধিক সার্ভারে একই রকম সফটওয়্যার এনভায়রনমেন্ট বজায় রাখতে সাহায্য করে, পাশাপাশি কনফিগারেশন ড্রিফট কমায়।
প্রোডাকশন এআই এনভায়রনমেন্টে সাধারণত নিম্নলিখিত টুলগুলো একীভূত করা হয়:
- MLflow এক্সপেরিমেন্ট ট্র্যাকিং এবং মডেল লাইফসাইকেল ম্যানেজমেন্টের জন্য।
- Hugging Face Transformers প্রি-ট্রেইন্ড মডেল এবং ফাউন্ডেশন মডেল ডেভেলপমেন্টের জন্য।
- Weights & Biases এক্সপেরিমেন্ট মনিটরিং এবং পারফরম্যান্স ভিজ্যুয়ালাইজেশনের জন্য।
- Docker পোর্টেবল এআই এনভায়রনমেন্টের জন্য।
- Kubernetes কন্টেইনার অর্কেস্ট্রেশন এবং ওয়ার্কলোড শিডিউলিংয়ের জন্য।
- Slurm হাই-পারফরম্যান্স কম্পিউটিং (HPC) এবং মাল্টি-জিপিউ ক্লাস্টারে জিপিউ শিডিউলিংয়ের জন্য।
এই প্ল্যাটফর্মগুলো রিসোর্স ব্যবহার উন্নত করে, ইনফ্রাস্ট্রাকচার ম্যানেজমেন্ট সহজ করে এবং বড় পরিসরে সহযোগিতামূলক এআই ডেভেলপমেন্টকে সমর্থন করে।
নিরাপত্তা এবং অপারেশনাল সর্বোত্তম অনুশীলন
প্রোডাকশন এআই ইনফ্রাস্ট্রাকচার নির্ভরযোগ্যতা, নিরাপত্তা এবং অপারেশনাল গভর্ন্যান্সকে মাথায় রেখে ডিজাইন করা উচিত।
প্রস্তাবিত অনুশীলনগুলোর মধ্যে রয়েছে:
- কী-বেসড অথেন্টিকেশন ব্যবহার করে SSH অ্যাক্সেস সীমিত করুন।
- ইনফ্রাস্ট্রাকচার এবং এআই ওয়ার্কলোডের জন্য রোল-বেসড অ্যাক্সেস কন্ট্রোল (RBAC) বাস্তবায়ন করুন।
- নেটওয়ার্ক পলিসি এবং ফায়ারওয়াল ব্যবহার করে এআই এনভায়রনমেন্ট বিভক্ত করুন।
- কোডে ক্রেডেনশিয়াল এমবেড না করে নিরাপদে সিক্রেট সংরক্ষণ করুন।
- NVIDIA ড্রাইভার, CUDA, cuDNN এবং AI ফ্রেমওয়ার্কগুলো ভার্সন কন্ট্রোলের আওতায় রাখুন।
- GPU তাপমাত্রা, PCIe ব্যান্ডউইথ, VRAM ব্যবহার, স্টোরেজ I/O এবং নেটওয়ার্ক পারফরম্যান্স নিয়মিত মনিটর করুন।
- ডেটাসেট, মডেল চেকপয়েন্ট, এক্সপেরিমেন্ট মেটাডেটা এবং কনফিগারেশন ফাইলের নিয়মিত ব্যাকআপ শিডিউল করুন।
- প্রোডাকশন AI ওয়ার্কলোডে প্রভাব ফেলার আগেই পারফরম্যান্স সমস্যা শনাক্ত করতে কেন্দ্রীভূত লগিং এবং ইনফ্রাস্ট্রাকচার মনিটরিং কনফিগার করুন।
AI GPU সার্ভার সলিউশন এবং ক্লাউড অপশন অন্বেষণ করা
ক্লাউড-ভিত্তিক AI GPU সার্ভার সলিউশন জনপ্রিয়, কারণ এগুলো সংগ্রহের সময় কমিয়ে দেয় এবং টিমগুলোকে একটি একক ইনস্ট্যান্স থেকে মাল্টি-নোড GPU ক্লাস্টারে দ্রুত স্কেল করার সুযোগ দেয়। এটি মডেল ট্রেনিং স্পাইক, স্বল্পমেয়াদী এক্সপেরিমেন্ট, প্রুফ-অফ-কনসেপ্ট কাজ এবং এমন ইনফারেন্স পরিবেশের জন্য উপযোগী যেখানে নমনীয় ভৌগোলিক ডিপ্লয়মেন্ট প্রয়োজন। একটি GPU ক্লাউড সার্ভার নতুন NVIDIA হার্ডওয়্যারে অ্যাক্সেস সহজ করতে পারে, বিশেষত যখন স্থানীয় হার্ডওয়্যার সরবরাহের সময় দীর্ঘ হয় অথবা যখন প্রতিষ্ঠানগুলো বড় অঙ্কের প্রাথমিক মূলধন ব্যয় এড়াতে চায়।
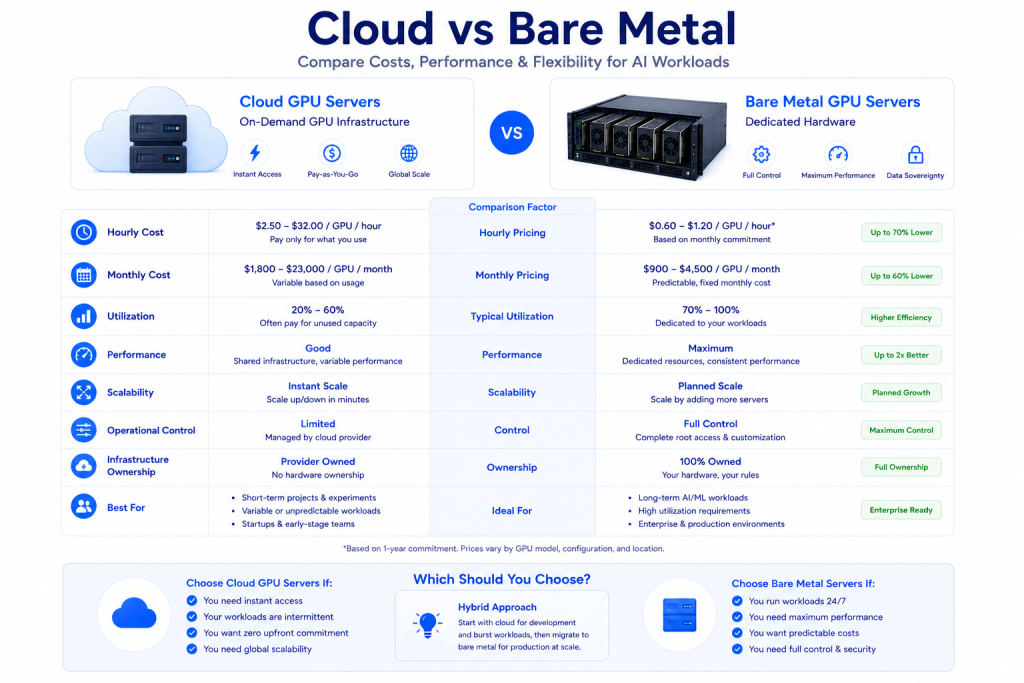
তবে ক্লাউড GPU হোস্টিং সবসময় প্রতিটি ওয়ার্কলোডের জন্য স্বয়ংক্রিয়ভাবে সেরা পছন্দ হয় না। সঠিক অপশনটি নির্ভর করে ব্যবহারের ধরন, ডেটা গ্র্যাভিটি, কমপ্লায়েন্স এবং অপারেশনাল মডেলের উপর। কিছু কোম্পানি ক্রমাগত ট্রেনিং করে এবং দীর্ঘমেয়াদী ডেডিকেটেড ইনফ্রাস্ট্রাকচার থেকে বেশি উপকৃত হয়, আবার কিছু কোম্পানির বেঞ্চমার্কিংয়ের জন্য বিভিন্ন ধরনের GPU-তে স্থিতিস্থাপক অ্যাক্সেস প্রয়োজন হয়। এই প্রেক্ষাপটে, Cloudoora-র মতো প্রোভাইডারদের প্রায়ই হার্ডওয়্যার প্রাপ্যতা, নেটওয়ার্কিং অপশন, ডিপ্লয়মেন্ট ফ্লেক্সিবিলিটি এবং AI-নির্দিষ্ট ওয়ার্কলোডের জন্য সহায়তার ভিত্তিতে বৃহত্তর সার্ভার হোস্টিং সলিউশনের পাশাপাশি মূল্যায়ন করা হয়।
দ্রুত প্রভিশনিং, সাময়িক স্কেলিং এবং নমনীয় টেস্টিংয়ের জন্য ক্লাউড GPU সার্ভার সবচেয়ে উপযুক্ত, আর ক্রমাগত ট্রেনিং লোড ও পূর্বানুমানযোগ্য দীর্ঘমেয়াদী খরচের জন্য প্রায়ই ডেডিকেটেড AI সার্ভার অধিক উপযুক্ত।
| অপশন | পারফরম্যান্স | স্কেলেবিলিটি | কস্ট মডেল | সেরা ব্যবহারের ক্ষেত্র |
|---|---|---|---|---|
| একক ক্লাউড GPU ইনস্ট্যান্স | ফোকাসড ট্রেনিং জবের জন্য ভালো | মাঝারি | ঘণ্টাভিত্তিক বা অন-ডিমান্ড | টেস্টিং, ফাইন-টিউনিং, স্বল্পমেয়াদী এক্সপেরিমেন্ট |
| মাল্টি-GPU ক্লাউড সার্ভার | উচ্চ স্থানীয় পারফরম্যান্স | ভালো | ঘণ্টাভিত্তিক অথবা রিজার্ভড | বড় মডেল ট্রেনিং |
| ডেডিকেটেড জিপিইউ বেয়ার মেটাল | অত্যন্ত উচ্চ এবং সামঞ্জস্যপূর্ণ | কম তাৎক্ষণিক স্কেলেবিলিটি | মাসিক অথবা চুক্তিভিত্তিক | ক্রমাগত ওয়ার্কলোড, স্থিতিশীল পাইপলাইন |
| ডিস্ট্রিবিউটেড জিপিইউ ক্লাস্টার | প্যারালাল ওয়ার্কলোডের জন্য সর্বোচ্চ | চমৎকার | জটিল, ব্যবহারভিত্তিক অথবা নির্দিষ্ট মূল্যের | এন্টারপ্রাইজ-স্কেল ট্রেনিং |
বাস্তব-জগতের ডিপ্লয়মেন্ট প্যাটার্ন সাধারণত তিনটি বিভাগে পড়ে। স্টার্টআপগুলো প্রায়ই মেশিন লার্নিংয়ের জন্য ক্লাউড জিপিইউ দিয়ে শুরু করে কারণ তাদের দ্রুততা এবং কম অপারেশনাল জটিলতা প্রয়োজন। গবেষণা দলগুলো বেসলাইন ট্রেনিংয়ের জন্য একটি ডেডিকেটেড এনভিডিয়া জিপিইউ সার্ভারের সাথে ক্লাউডে বার্স্ট ক্যাপাসিটি যুক্ত করতে পারে। বড় প্রতিষ্ঠানগুলো প্রায়ই হাইব্রিড এআই ইনফ্রাস্ট্রাকচার চালায়, যেখানে সংবেদনশীল ডেটাসেটের জন্য লোকাল বা বেয়ার মেটাল জিপিইউ এবং ওভারফ্লো, পরীক্ষা-নিরীক্ষা, অথবা শেষ ব্যবহারকারীর কাছাকাছি ইনফারেন্সের জন্য ক্লাউড জিপিইউ ব্যবহার করা হয়।
- ক্লাউডের সুবিধাসমূহ: দ্রুত প্রোভিশনিং, নমনীয় স্কেলিং, কমে যাওয়া হার্ডওয়্যার রক্ষণাবেক্ষণ
- ডেডিকেটেডের সুবিধাসমূহ: পূর্বাভাসযোগ্য পারফরম্যান্স, কোনো “নয়সি নেইবার” সমস্যা নেই, স্টোরেজ এবং নেটওয়ার্কিংয়ের ওপর শক্তিশালী নিয়ন্ত্রণ
- হাইব্রিডের সুবিধাসমূহ: ভারসাম্যপূর্ণ খরচ, ভৌগোলিক নমনীয়তা, গবেষণা ও প্রোডাকশন ওয়ার্কলোডের মধ্যে সহজ বিভাজন
এআই ট্রেনিংয়ের জন্য জিপিইউ সার্ভারের ভবিষ্যৎ প্রবণতা
মেশিন লার্নিং মডেলগুলো যত বড়, জটিল এবং ক্রমবর্ধমানভাবে মাল্টিমোডাল হয়ে উঠছে, এআই ইনফ্রাস্ট্রাকচারও ততই বিবর্তিত হচ্ছে। ভবিষ্যতের জিপিইউ সার্ভারগুলো শুধুমাত্র উচ্চতর কম্পিউট পারফরম্যান্স প্রদানের ওপরই নয়, বরং মেমোরি ক্ষমতা, মেমোরি ব্যান্ডউইথ, শক্তি দক্ষতা এবং পরবর্তী প্রজন্মের এআই ওয়ার্কলোড সমর্থনের জন্য ইন্টারকানেক্ট প্রযুক্তির উন্নতির ওপরও গুরুত্ব দেবে। প্রতিষ্ঠানগুলো যখন আরও বড় ফাউন্ডেশন মডেল ট্রেনিং করছে, এজেন্টিক এআই সিস্টেম ডিপ্লয় করছে এবং দীর্ঘতর কনটেক্সট উইন্ডো প্রসেস করছে, তখন রও কম্পিউট পারফরম্যান্সের মতোই ইনফ্রাস্ট্রাকচার স্কেলেবিলিটিও গুরুত্বপূর্ণ হয়ে উঠবে।
নতুন জিপিইউ প্ল্যাটফর্ম যেমন এনভিডিয়া এইচ২০০ (NVIDIA H200), NVIDIA Blackwell B200, NVIDIA RTX PRO 6000, এবং AMD Instinct MI300X এই পরবর্তী প্রজন্মের এআই ইনফ্রাস্ট্রাকচারের প্রতিনিধিত্ব করে। এই অ্যাক্সিলারেটরগুলি উল্লেখযোগ্যভাবে বৃহত্তর হাই-ব্যান্ডউইথ মেমরি (HBM), দ্রুততর জিপিইউ-টু-জিপিইউ যোগাযোগ, উচ্চতর এআই থ্রুপুট এবং লার্জ ল্যাঙ্গুয়েজ মডেল (LLM), মাল্টিমোডাল এআই সিস্টেম, রিট্রিভাল-অগমেন্টেড জেনারেশন (RAG) এবং অন্যান্য মেমরি-নিবিড় ডিপ লার্নিং ওয়ার্কলোড প্রশিক্ষণের জন্য উন্নত দক্ষতা প্রদান করে। এই উন্নতিগুলি ইনফ্রাস্ট্রাকচার বাধা কমাতে সাহায্য করে এবং প্রতিষ্ঠানগুলিকে ক্রমবর্ধমান জটিল এআই মডেলগুলি আরও দক্ষতার সাথে প্রশিক্ষণ দিতে সক্ষম করে।
ভবিষ্যতের এআই প্ল্যাটফর্মগুলি আরও বেশি নির্ভর করবে মাল্টি-জিপিইউ সার্ভার, জিপিইউ ক্লাস্টার, NVLink, NVSwitch, PCIe Gen5, এবং উচ্চ-গতির নেটওয়ার্কিং প্রযুক্তির উপর, যেমন InfiniBand এবং RDMA। এই প্রযুক্তিগুলি জিপিইউগুলির মধ্যে যোগাযোগের বিলম্ব হ্রাস করে এবং একাধিক সার্ভার জুড়ে এআই ওয়ার্কলোডকে দক্ষতার সাথে স্কেল করতে সক্ষম করে বিতরণকৃত প্রশিক্ষণের কার্যক্ষমতা উন্নত করে।
সফটওয়্যার স্তরে, এআই ইনফ্রাস্ট্রাকচার ক্রমবর্ধমানভাবে স্বয়ংক্রিয় হয়ে উঠছে এমন প্ল্যাটফর্মের মাধ্যমে, যেমন Kubernetes, Docker, Slurm, Ray, এবং ডিস্ট্রিবিউটেড এআই ফ্রেমওয়ার্ক যেমন PyTorch Distributed, DeepSpeed, এবং Hugging Face Accelerate। এই টুলগুলো এন্টারপ্রাইজ এআই পরিবেশে ওয়ার্কলোড অর্কেস্ট্রেশন, জিপিইউ শিডিউলিং, ডিস্ট্রিবিউটেড ট্রেনিং এবং রিসোর্স অপ্টিমাইজেশন সহজ করে তোলে।
এআই গ্রহণের গতি যত বাড়ছে, প্রতিষ্ঠানগুলোর উচিত শুধুমাত্র বর্তমান পারফরম্যান্সের চাহিদার ভিত্তিতে নয়, বরং দীর্ঘমেয়াদি স্কেলেবিলিটি, আপগ্রেড নমনীয়তা এবং ইকোসিস্টেম সামঞ্জস্যতার ভিত্তিতেও জিপিইউ ইনফ্রাস্ট্রাকচার মূল্যায়ন করা। পরবর্তী প্রজন্মের জিপিইউ আর্কিটেকচার, সম্প্রসারণযোগ্য স্টোরেজ, হাই-স্পিড নেটওয়ার্কিং এবং আধুনিক এআই ফ্রেমওয়ার্ক সমর্থনকারী এআই ইনফ্রাস্ট্রাকচারে বিনিয়োগ করলে ভবিষ্যতের মেশিন লার্নিং, জেনারেটিভ এআই, সায়েন্টিফিক কম্পিউটিং এবং এন্টারপ্রাইজ এআই ওয়ার্কলোডের জন্য একটি শক্তিশালী ভিত্তি তৈরি হয়।
উপসংহার
এআই ট্রেনিংয়ের জন্য সেরা জিপিইউ সার্ভার হলো সেটিই, যা আপনার ওয়ার্কলোড, ফ্রেমওয়ার্ক স্ট্যাক, স্টোরেজ চাহিদা এবং স্কেলিং মডেলের সাথে সবচেয়ে ভালোভাবে মানানসই। ছোট থেকে মাঝারি আকারের প্রজেক্টের জন্য, শক্তিশালী এনভিএমই পারফরম্যান্স এবং পর্যাপ্ত ভিআরএএম সহ একটি সুসংগঠিত সিঙ্গেল বা মাল্টি-জিপিইউ সিস্টেম চমৎকার ফলাফল দিতে পারে। বড় ডিপ লার্নিং পাইপলাইনের জন্য, দ্রুতগতির ইন্টারকানেক্ট, কন্টেইনার অর্কেস্ট্রেশন এবং সুচিন্তিত ডেটা ডিজাইন সম্বলিত ডিস্ট্রিবিউটেড এআই ইনফ্রাস্ট্রাকচার শুধুমাত্র জিপিইউ সংখ্যার চেয়ে অনেক বেশি গুরুত্বপূর্ণ হয়ে ওঠে।
আপনি যদি জিপিইউ সার্ভার হোস্টিং, একটি ডেডিকেটেড এআই ট্রেনিং সার্ভার, অথবা একটি নমনীয় জিপিইউ ক্লাউড সার্ভার বেছে নেন, সবচেয়ে কার্যকর কৌশল হলো সম্পূর্ণ স্ট্যাকটি মূল্যায়ন করা: এনভিডিয়া জিপিইউ শ্রেণি, কুডা এবং সিউডিএনএন সমর্থন, সিপিইউ ও র্যামের ভারসাম্য, স্টোরেজ আইওপিএস, নেটওয়ার্ক থ্রুপুট এবং অপারেশনাল টুলিং। ক্লাউড এবং ডেডিকেটেড পরিবেশ তুলনা করার সময় ক্রেতাদের ব্যবহারের হার, কমপ্লায়েন্স এবং দীর্ঘমেয়াদি খরচও বিবেচনা করা উচিত। এই বিষয়গুলো সঠিকভাবে মিলে গেলে, আপনার মেশিন লার্নিংয়ের জন্য জিপিইউ সার্ভার ট্রেনিং, ডিপ্লয়মেন্ট এবং ভবিষ্যৎ প্রবৃদ্ধির জন্য একটি নির্ভরযোগ্য প্ল্যাটফর্মে পরিণত হয়।
সচরাচর জিজ্ঞাসিত প্রশ্ন
এআই ট্রেনিংয়ের জন্য কত জিপিইউ ভিআরএএম প্রয়োজন?
প্রয়োজনীয় জিপিইউ ভিআরএএমের পরিমাণ নির্ভর করে আপনার এআই মডেলের আকার, ডেটাসেট, ব্যাচ সাইজ এবং ট্রেনিং ফ্রেমওয়ার্কের উপর। ছোট মেশিন লার্নিং প্রজেক্ট এবং কম্পিউটার ভিশন মডেলগুলো প্রায়শই ১৬–২৪ জিবি ভিআরএএম সম্বলিত জিপিইউতে কার্যকরভাবে চলে, অন্যদিকে বড় ভাষা মডেল (এলএলএম) ফাইন-টিউন করার জন্য সাধারণত ৪৮ জিবি বা তার বেশি প্রয়োজন হয়। এন্টারপ্রাইজ এআই ওয়ার্কলোড, ফাউন্ডেশন মডেল ট্রেনিং এবং দীর্ঘ-কনটেক্সট এলএলএমের জন্য এনভিএলিংকের মাধ্যমে সংযুক্ত এনভিডিয়া A100, H100, বা H200 জিপিইউ সম্বলিত মাল্টি-জিপিইউ সার্ভারের প্রয়োজন হতে পারে। পর্যাপ্ত জিপিইউ মেমরি নির্বাচন করলে ট্রেনিং স্থিতিশীলতা উন্নত হয়, বড় ব্যাচ সাইজ ব্যবহার করা যায় এবং ডিপ লার্নিং ওয়ার্কলোডের সময় মেমরি বটলনেক কমে যায়।
একটি সিঙ্গেল জিপিইউ সার্ভারে কি এআই মডেল ট্রেনিং করা সম্ভব?
হ্যাঁ। একটি সিঙ্গেল জিপিইউ সার্ভার অনেক এআই ওয়ার্কলোডের জন্য যথেষ্ট, যেমন কম্পিউটার ভিশন, রেকমেন্ডেশন সিস্টেম, স্টেবল ডিফিউশন, জেনারেটিভ এআই পরীক্ষা-নিরীক্ষা এবং ছোট ভাষা মডেল ফাইন-টিউনিং। ডেটাসেট এবং মডেল প্যারামিটার বাড়ার সাথে সাথে, প্রতিষ্ঠানগুলো প্রায়শই ট্রেনিংয়ের গতি বাড়াতে এবং ডিস্ট্রিবিউটেড ডিপ লার্নিং সমর্থন করতে মাল্টি-জিপিইউ সার্ভারে স্থানান্তরিত হয়। জিপিইউ সার্ভার নির্বাচন করা উচিত ওয়ার্কলোডের জটিলতার উপর ভিত্তি করে, শুধুমাত্র সবচেয়ে বড় উপলব্ধ জিপিইউ বেছে নেওয়ার পরিবর্তে।
কখন একটি সিঙ্গেল জিপিইউর পরিবর্তে মাল্টি-জিপিইউ সার্ভার বেছে নেওয়া উচিত?
একটি মাল্টি-জিপিইউ সার্ভার তখন উপকারী হয়ে ওঠে যখন বড় ভাষা মডেল ট্রেনিং করা হয়, বিশাল ডেটাসেট প্রসেস করা হয়, অথবা ডিস্ট্রিবিউটেড কম্পিউটিংয়ের মাধ্যমে ট্রেনিং সময় কমানো প্রয়োজন হয়। এনভিলিংক, এনভিসুইচ, আরডিএমএ এবং ইনফিনিব্যান্ডের মতো প্রযুক্তিগুলো একাধিক জিপিইউকে দক্ষতার সাথে যোগাযোগ করতে সক্ষম করে, যা এন্টারপ্রাইজ এআই ট্রেনিংয়ের জন্য স্কেলেবিলিটি উন্নত করে। ফাউন্ডেশন মডেল, মাল্টিমোডাল এআই সিস্টেম, বা বড় আকারের ডিপ লার্নিং পাইপলাইন তৈরিকারী প্রতিষ্ঠানগুলো সাধারণত সিঙ্গেল-জিপিইউ কনফিগারেশনের চেয়ে মাল্টি-জিপিইউ ইনফ্রাস্ট্রাকচার থেকে বেশি উপকৃত হয়।
এআই ট্রেনিংয়ের জন্য ক্লাউড জিপিইউ হোস্টিং নাকি বেয়ার মেটাল জিপিইউ সার্ভার বেশি উপযুক্ত?
সঠিক ডেপ্লয়মেন্ট মডেল নির্ভর করে ওয়ার্কলোডের সময়কাল, ইনফ্রাস্ট্রাকচার প্রয়োজনীয়তা এবং পরিচালনাগত লক্ষ্যের উপর। ক্লাউড জিপিইউ হোস্টিং একটি নমনীয়, চাহিদা-ভিত্তিক জিপিইউ রিসোর্স প্রদান করে যা এআই পরীক্ষা-নিরীক্ষা, স্বল্পমেয়াদী মডেল ট্রেনিং এবং ডেভেলপমেন্ট প্রজেক্টের জন্য উপযোগী। অন্যদিকে, বেয়ার মেটাল জিপিইউ সার্ভার ডেডিকেটেড হার্ডওয়্যার, পূর্বানুমানযোগ্য পারফরম্যান্স এবং সম্পূর্ণ ইনফ্রাস্ট্রাকচার নিয়ন্ত্রণ প্রদান করে, যা একে ক্রমাগত এআই ট্রেনিং, প্রোডাকশন মেশিন লার্নিং পাইপলাইন এবং এন্টারপ্রাইজ এআই ওয়ার্কলোডের জন্য বেশি উপযোগী করে তোলে। প্রতিষ্ঠানগুলোর উচিত শুধুমাত্র জিপিইউ স্পেসিফিকেশনের দিকে না তাকিয়ে স্কেলেবিলিটি, নিরাপত্তা, নেটওয়ার্কিং, স্টোরেজ পারফরম্যান্স এবং দীর্ঘমেয়াদী ইনফ্রাস্ট্রাকচার খরচ তুলনা করা।
লার্জ ল্যাঙ্গুয়েজ মডেল (এলএলএম) ট্রেনিংয়ের জন্য কোন জিপিইউ সবচেয়ে ভালো?
এলএলএম ট্রেনিংয়ের জন্য সেরা জিপিইউ নির্বাচন নির্ভর করে মডেলের আকার এবং উপলব্ধ ইনফ্রাস্ট্রাকচারের উপর। এনভিডিয়া এইচ১০০ এবং এইচ২০০-এর মতো জিপিইউগুলো এন্টারপ্রাইজ-স্কেল লার্জ ল্যাঙ্গুয়েজ মডেল ট্রেনিংয়ের জন্য ব্যাপকভাবে ব্যবহৃত হয়, কারণ এগুলো উচ্চ-ব্যান্ডউইথ মেমরি, টেনসর কোর অ্যাক্সিলারেশন এবং ডিস্ট্রিবিউটেড এআই ট্রেনিংয়ের সহায়তা প্রদান করে। এনভিডিয়া এ১০০ এখনো অনেক এন্টারপ্রাইজ মেশিন লার্নিং ওয়ার্কলোডের জন্য একটি শক্তিশালী পছন্দ, আর আরটিএক্স ৪০৯০ এবং আরটিএক্স ৬০০০ এডা সাধারণত এলএলএম ফাইন-টিউনিং, গবেষণা এবং জেনারেটিভ এআই ডেভেলপমেন্টের জন্য নির্বাচিত হয়।
এআই ট্রেনিংয়ের জন্য এনভিএমই এসএসডি স্টোরেজ কেন গুরুত্বপূর্ণ?
এন্টারপ্রাইজ এনভিএমই এসএসডি স্টোরেজ ডেটাসেট লোডিং সময় কমিয়ে, চেকপয়েন্ট সংরক্ষণ দ্রুততর করে এবং সামগ্রিক ইনপুট/আউটপুট থ্রুপুট বাড়িয়ে এআই ট্রেনিং পারফরম্যান্স উন্নত করে। ডিপ লার্নিং ফ্রেমওয়ার্কগুলো ট্রেনিংয়ের সময় ক্রমাগত ডেটাসেট পড়ে এবং মডেল চেকপয়েন্ট সংরক্ষণ করে। উচ্চ-গতির এনভিএমই স্টোরেজ স্টোরেজ বটলনেকের কারণে সৃষ্ট জিপিইউ নিষ্ক্রিয় সময় কমিয়ে দেয় এবং স্যাটা এসএসডি বা প্রচলিত হার্ড ড্রাইভের তুলনায় দ্রুততর পরীক্ষা-নিরীক্ষার সুযোগ দেয়। এন্টারপ্রাইজ এআই ইনফ্রাস্ট্রাকচারের ক্ষেত্রে, স্টোরেজ পারফরম্যান্স প্রায়ই জিপিইউ পারফরম্যান্সের মতোই গুরুত্বপূর্ণ।
এআই ট্রেনিংয়ের জন্য কি এএমডি জিপিইউ ব্যবহার করা যায়?
হ্যাঁ। এএমডি ইনস্টিংক্ট এমআই৩০০এক্স-এর মতো এএমডি জিপিইউগুলো আরওসিএম সফটওয়্যার প্ল্যাটফর্মের মাধ্যমে এন্টারপ্রাইজ এআই ট্রেনিং, বৈজ্ঞানিক গণনা এবং উচ্চ-পারফরম্যান্স কম্পিউটিং সমর্থন করে। যদিও সিইউডিএ সামঞ্জস্য এবং ব্যাপক ফ্রেমওয়ার্ক সমর্থনের কারণে এনভিডিয়া জিপিইউ বর্তমানে এআই ইকোসিস্টেমে প্রাধান্য বিস্তার করে আছে, তবুও এএমডি মেশিন লার্নিং, জেনারেটিভ এআই এবং বড় পরিসরের ডিপ লার্নিং ওয়ার্কলোডের জন্য তাদের এআই সক্ষমতা ক্রমাগত সম্প্রসারিত করে চলেছে। উপযুক্ত প্ল্যাটফর্ম নির্ভর করে সফটওয়্যার সামঞ্জস্যতা, ইনফ্রাস্ট্রাকচার প্রয়োজনীয়তা এবং প্রতিষ্ঠানের পছন্দের উপর।
আপনার এআই প্রজেক্টের জন্য সঠিক জিপিইউ সার্ভার কীভাবে নির্বাচন করবেন?
সঠিক জিপিইউ সার্ভার নির্বাচন শুরু হয় সবচেয়ে দ্রুতগতির হার্ডওয়্যার বেছে নেওয়ার পরিবর্তে আপনার এআই ওয়ার্কলোড বোঝার মাধ্যমে। প্রতিষ্ঠানগুলোর উচিত জিপিইউ আর্কিটেকচার, ভিআরএএম ক্ষমতা, সিপিইউ পারফরম্যান্স, সিস্টেম র্যাম, এন্টারপ্রাইজ এনভিএমই এসএসডি স্টোরেজ, নেটওয়ার্কিং ব্যান্ডউইথ, ডেপ্লয়মেন্ট মডেল এবং ভবিষ্যৎ স্কেলেবিলিটিকে একটি সম্পূর্ণ ইনফ্রাস্ট্রাকচার প্ল্যাটফর্ম হিসেবে মূল্যায়ন করা। ওয়ার্কলোডের প্রয়োজনীয়তার সাথে ইনফ্রাস্ট্রাকচার মিলিয়ে নিলে জিপিইউ ব্যবহারের দক্ষতা বৃদ্ধি পায়, ট্রেনিং সময় কমে, এবং মেশিন লার্নিং, ডিপ লার্নিং ও এন্টারপ্রাইজ এআই অ্যাপ্লিকেশনের জন্য আরও সাশ্রয়ী ভিত্তি তৈরি হয়।
এআই ট্রেনিংয়ের জন্য জিপিইউ সার্ভার ভাড়া নেওয়া নাকি কেনা—কোনটি ভালো?
অস্থায়ী এআই প্রজেক্ট, মৌসুমী ওয়ার্কলোড বা পরীক্ষামূলক গবেষণা পরিচালনাকারী প্রতিষ্ঠানগুলো সাধারণত জিপিইউ সার্ভার ভাড়া নেওয়ার মাধ্যমে উপকৃত হয়, কারণ ক্লাউড ইনফ্রাস্ট্রাকচার দীর্ঘমেয়াদী হার্ডওয়্যার বিনিয়োগ ছাড়াই দ্রুত প্রোভিশনিং এবং নমনীয় স্কেলিং সুবিধা প্রদান করে। অন্যদিকে, যেসব ব্যবসা ক্রমাগত মেশিন লার্নিং পাইপলাইন, এন্টারপ্রাইজ এআই অ্যাপ্লিকেশন, বা লার্জ ল্যাঙ্গুয়েজ মডেল ট্রেনিং পরিচালনা করে, তারা ডেডিকেটেড বেয়ার মেটাল জিপিইউ সার্ভারের মাধ্যমে দীর্ঘমেয়াদে ভালো মূল্য পেতে পারে, যা পূর্বানুমানযোগ্য পারফরম্যান্স, সম্পূর্ণ ইনফ্রাস্ট্রাকচার নিয়ন্ত্রণ এবং ধারাবাহিক জিপিইউ প্রাপ্যতা নিশ্চিত করে।